
Um ambiente de homologação precisa de relacionamentos realistas e de registros representativos. Uma aplicação de filial precisa de um catálogo atualizado. Uma integração precisa de campos escolhidos numa estrutura diferente. Nenhuma dessas necessidades pede automaticamente uma cópia completa e intacta de um banco de produção.
O dbSlice leva essas decisões para um fluxo explícito: escolha uma origem, selecione os registros, mapeie as colunas de destino, configure o mascaramento e execute uma transferência que dá para inspecionar e repetir. O resultado é um jeito prático de mover dados úteis controlando quais valores chegam ao destino.
O produto Windows traz uma interface gráfica e uma CLI, com suporte a SQL Server, PostgreSQL, Oracle, MySQL, MariaDB, Firebird, SQLite e Caché/IRIS, e a MongoDB, Cassandra, Elasticsearch, Couchbase e Redis só como destino. A página pública do produto descreve os recursos de filtro, mapeamento, mascaramento, conciliação, jobs salvos e recuperação operacional. Visão geral do produto dbSlice
1. Três decisões fazem parte de toda transferência
Antes de mover uma linha, responda três perguntas: Quais registros são necessários? Quais colunas vão para o destino? Quais valores precisam mudar antes de serem gravados?
Define the row subset
Preserve the matching key
Before the target write
Validate the outcome
O caminho da sincronia mapeia e transforma os valores antes de gravar os lotes de destino. A exportação para arquivo é uma operação à parte, com as suas próprias opções de formato e de mascaramento.
A seleção reduz o escopo da operação. O mapeamento deixa explícitas as diferenças entre os esquemas. O mascaramento muda os valores que um ambiente posterior recebe. Juntos, esses controles atendem tarefas como atualizar um ambiente de teste, preparar uma migração, alimentar um processo externo ou manter um banco local de consulta.
Por exemplo, um catálogo de serviços pode precisar de descrições e categorias numa filial, enquanto um ambiente de teste do suporte pode precisar dos relacionamentos dos clientes sem e-mails de clientes utilizáveis. São conjuntos de dados diferentes e devem ser configurados como operações diferentes.
2. Escolha uma fatia útil e preserve os relacionamentos dela
Em Synchronize, escolha a conexão de origem e uma tabela, view ou consulta SELECT. Escolha a conexão de destino, o objeto de destino e a chave de casamento. Aplique uma condição WHERE na origem quando o destino precisa só de um subconjunto.
Um catálogo de serviços sintético poderia usar:
category_id = 1
A seleção também cria uma questão de dependência: os registros de categoria e de tipo necessários existem no destino? Transfira os registros pais antes dos dependentes e valide as referências depois da carga. Uma transferência filtrada, sozinha, não define uma fatia completa e consciente das dependências de todas as tabelas relacionadas.
Use Map columns quando os nomes diferem ou quando o destino precisa de outra projeção. Um mapeamento pode ligar full_name a display_name, por exemplo, mantendo id como chave de casamento. Revise tamanhos, nulos, padrões do destino e tipos de dados antes de rodar a operação. Omitir uma coluna obrigatória do destino só funciona quando o destino consegue fornecer um valor válido.
Quando reduzir o que é lido da origem é em si um requisito, use uma view ou um SELECT que devolva só as colunas necessárias, incluindo uma chave adequada. Tirar uma coluna do mapeamento de destino não deve ser tratado como prova de que ela nunca foi lida da origem.
3. Mascare os valores antes da gravação no destino
O ponto importante é onde o mascaramento acontece: dentro do processo de transferência. Na implementação de sincronia revisada, as linhas de origem são lidas, as linhas de destino são montadas pelos mapeamentos, os valores escolhidos são transformados e o lote resultante é gravado no destino.
Isso evita um fluxo que primeiro carrega os valores originais numa tabela de teste e só depois os mascara. Com o mascaramento bem configurado, os valores pertinentes mudam antes de essa gravação acontecer.
id: 42
name: Alice Example
email: alice@example.testid: preserved key
name: template:Customer {key}
email: template:user-{key}@example.testid: 42
name: Customer 42
email: user-42@example.testValores apenas ilustrativos. A chave continua disponível para casar os registros; o nome e o e-mail são substituídos por regras explícitas de mapeamento.
Na janela de mapeamento, ative a ofuscação para as colunas pertinentes que não são chave e informe uma regra onde uma máscara padrão não serve. A implementação revisada aceita estes exemplos:
| Regra | Entrada sintética | Resultado | Ponto de atenção |
|---|---|---|---|
fixed:REDACTED |
Alice Example |
REDACTED |
Todas as linhas recebem a mesma substituição; confira as constraints de unicidade. |
template:Customer {key} |
Alice Example, chave 42 |
Customer 42 |
Produz um rótulo legível, mas expõe a chave mantida. |
template:user-{key}@example.test |
alice@example.test, chave 42 |
user-42@example.test |
Troca a caixa de correio e o domínio originais por um valor de teste. |
keep:2,* |
ABCDE |
AB*** |
Mantém os dois primeiros caracteres, não os dois últimos. |
email: |
alice@example.test |
al***@example.test |
Mantém um prefixo e o domínio original. |
cpf: |
123.456.789-00 |
***.***.***-** |
Troca os dígitos e preserva a pontuação; não gera um identificador substituto válido. |
Estas saídas foram conferidas com a função de mascaramento usando valores sintéticos. Não são resultados da cópia de uma tabela de clientes em uso.
Sem regra explícita, o mascaramento é feito pelo tipo. Na implementação revisada, por exemplo: zero para valores numéricos, falso para booleanos, uma data histórica fixa para datas e uma string curta mascarada para texto. Essas substituições podem mudar o significado de negócio, juntar valores únicos ou conflitar com a validação do destino. Confira a saída e use regras explícitas onde for preciso. Uma regra não reconhecida volta para a máscara padrão; então valide a grafia da regra, além dos valores resultantes.
4. Preserve as chaves de propósito
As chaves são necessárias para casar os registros e manter os relacionamentos. A interface de mapeamento da sincronia protege do mascaramento a chave escolhida e as chaves estrangeiras reconhecidas no destino. A ofuscação da exportação e a do job resolvem um escopo padrão mais amplo, que exclui a chave escolhida e as chaves primárias e estrangeiras reconhecidas.
Esse comportamento ajuda a manter um conjunto de dados utilizável, mas os identificadores mantidos ainda merecem revisão. Um ID de cliente, uma chave natural ou uma cadeia de chaves estrangeiras pode ligar uma linha a outras informações. Os resultados de consultas também podem não ter os metadados de chave estrangeira disponíveis para uma tabela.
Não suponha que marcar uma opção de ofuscação significa que todo campo sensível foi encontrado e removido. Revise texto livre, identificadores secundários, relacionamentos não mapeados e qualquer valor mantido por máscaras parciais. Se o conjunto de dados pretendido exige a substituição coerente de identificadores em todo um grafo de relacionamentos, desenhe essa transformação de forma explícita, em vez de mudar uma chave isoladamente.
5. O que "durante a cópia" significa para a proteção
Numa sincronia direta de banco para banco, o serviço revisado passa os lotes pela memória e não precisa de um despejo intermediário em CSV ou JSON. Isso pode reduzir o número de arquivos com dados envolvidos numa atualização.
É uma afirmação mais estreita do que dizer que nunca pode existir nenhum dado ou arquivo intermediário. O aplicativo precisa ler os valores originais antes de mascará-los. Logs do banco, memória da máquina, capturas de diagnóstico e logs operacionais têm os seus próprios requisitos de proteção. Uma operação de Export cria um arquivo de saída de propósito.
O mascaramento também é diferente de criptografia em trânsito e de criptografia em repouso. Configure a segurança da conexão com o banco, proteja as credenciais, restrinja o acesso aos arquivos gerados e aplique a política de retenção adequada ao ambiente. Esses controles servem a propósitos diferentes.
Evite descrever uma saída mascarada como automaticamente anônima ou automaticamente conforme o GDPR ou a LGPD. O EDPB distingue a pseudonimização, que reduz a possibilidade de ligação, da anonimização, que remove o vínculo com um indivíduo. Uma regra de mascaramento, sozinha, não resolve essa distinção para um conjunto de dados. EDPB: anonimização e pseudonimização
A contribuição prática do produto é a transformação configurável antes da entrega. A conformidade depende do conjunto de dados, das informações que restam, dos destinatários e dos controles organizacionais e técnicos em volta.
6. Escolha o comportamento da sincronia
O modo escolhido define o efeito no destino. Faça desse efeito parte da definição da operação, junto com o filtro e o mascaramento.
| Modo | Uso pretendido | Ponto a revisar |
|---|---|---|
| Initial load / só inserir | Preencher um destino preparado | Chaves e constraints existentes podem afetar a inserção. |
| Insert new | Acrescentar os registros cujas chaves não estão presentes | Os registros existentes não são atualizados. |
| Upsert | Inserir as chaves que faltam e atualizar os registros correspondentes | As linhas ausentes da origem escolhida não são excluídas automaticamente. |
| Update existing only | Atualizar os registros que já existem | Os registros que faltam no destino não são inseridos. |
| Full reload | Substituir o conteúdo do destino numa carga nova | Revise o efeito destrutivo e o plano de recuperação antes de executar. |
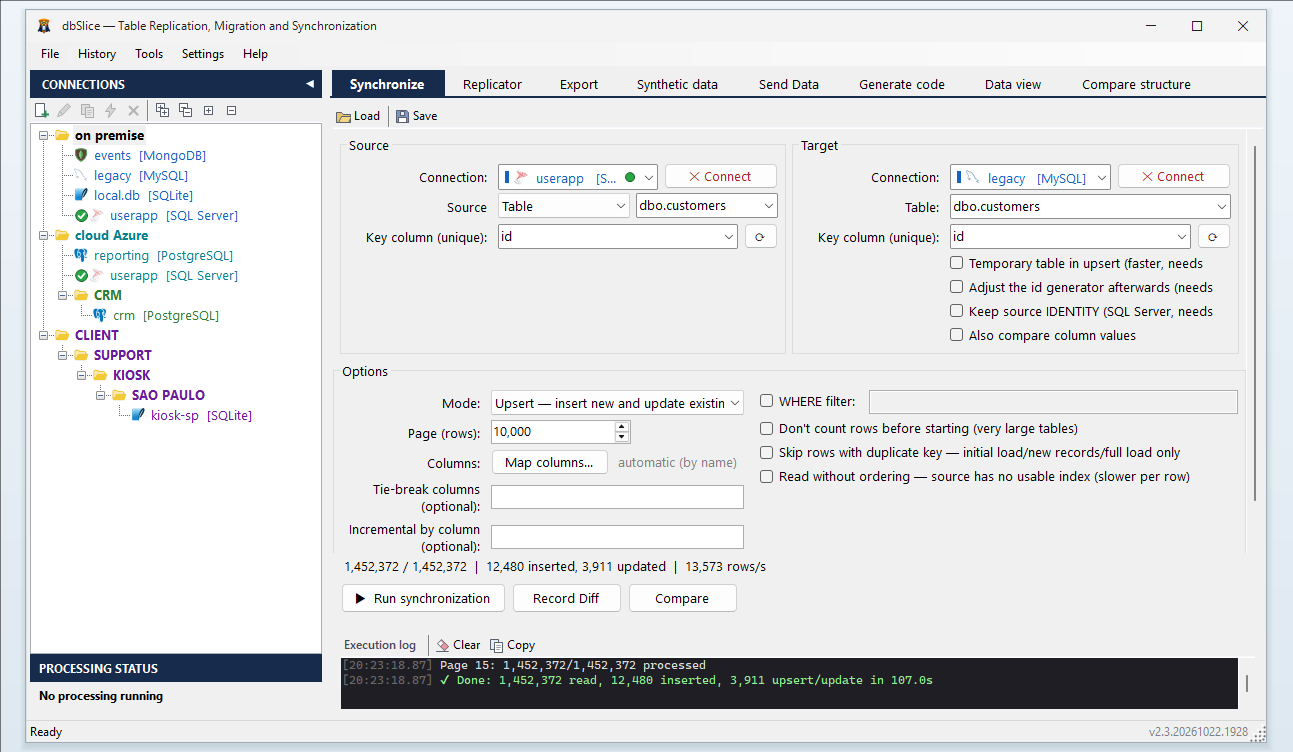
A questão da exclusão importa ainda mais com dados filtrados. Se um item sai da categoria escolhida, ele pode sumir da próxima seleção da origem e continuar num destino Upsert. Defina como os registros obsoletos ou fora do escopo serão tratados.
O processamento em lotes torna as transferências grandes administráveis, e o pipeline de sincronia revisado pode sobrepor leitura e gravação. Isso não é promessa de vazão ilimitada nem de uma única transação cobrindo o conjunto de dados inteiro. Escolha um tamanho de página adequado à largura das linhas, ao comportamento de gravação do destino, à rede e à memória disponível.
7. Recuperação: novas tentativas e pontos de controle têm escopo definido
O serviço de sincronia atual inclui novas tentativas para exceções classificadas como passageiras. No código revisado, uma operação que pode ser repetida tem até três tentativas, com esperas de 500 ms e 1 segundo antes das tentativas seguintes. As leituras de página ordenadas e as gravações de lote no destino usam esse mecanismo.
Isso resolve algumas interrupções temporárias sem exigir que o operador recomece na hora. Não resolve dados inválidos, falta de permissão, falhas de conexão persistentes nem todos os erros possíveis do banco. Depois de esgotadas as tentativas, a falha ainda precisa de atenção.
O suporte a pontos de controle registra o progresso depois dos lotes concluídos nas operações elegíveis. O serviço revisado exclui desse caminho o streaming sem ordenação e a paginação com desempate por chave composta; essas configurações não devem ser anunciadas como tendo o mesmo comportamento de retomada. Confirme as opções de recuperação expostas pela versão instalada e teste com o provider e o modo escolhidos.
Um lote concluído e o seu ponto de controle também são eventos diferentes. O desenho da recuperação deve considerar uma confirmação de gravação ou um salvamento de ponto de controle interrompidos. Revise o estado do destino antes de rodar de novo uma carga que falhou, principalmente quando há inserção, triggers ou outros efeitos colaterais.
A promessa útil é um tratamento limitado de novas tentativas e uma recuperação de progresso suportada. Não é recuperação automática de qualquer falha nem garantia de entrega exatamente uma vez num sistema distribuído inteiro.
8. De um destino a modelos de leitura locais em SQLite
O mesmo fluxo de transferência controlada pode preparar um catálogo SQLite local para uma aplicação ou filial. Cada destino precisa de escopo, agenda de atualização, processo de validação e política de atualidade explícitos.
Por exemplo, um catálogo pode tolerar uma atualização agendada, enquanto uma transação que exige o estoque atual ainda precisa usar o sistema oficial. Durante uma queda de conexão, a cópia local tem o último estado entregue com sucesso. A aplicação decide quais funções podem usá-la e quando esse estado está velho demais.
O caminho de transferência revisado lê tabelas, views ou consultas. Não deduza CDC nativo por log de transações a partir de uma ilustração de um motor de sincronia. Agendar transferências repetidas, ou filtrar por um timestamp mantido pela aplicação, é diferente de capturar cada mudança confirmada no banco. A seleção incremental precisa das suas próprias regras para atualizações, chegadas atrasadas e exclusões.
Da mesma forma, uma origem ligada a muitos ícones de SQLite é um conceito de implantação, não prova de um plano de controle de frota embutido. Distribuir para muitos nós exige gestão dos pontos de destino, agendamento, limites de concorrência, monitoramento, licenciamento adequado à implantação e decisões de consistência no nível da aplicação. Comece com um destino validado antes de aumentar o número de consumidores.
9. Monte um fluxo repetível pela interface e pela CLI
Para uma primeira sincronia mascarada, use a interface gráfica para deixar a operação revisável:
- Escolha as conexões de origem e de destino e confirme os ambientes pretendidos.
- Escolha o objeto de origem, o objeto de destino e as chaves de casamento.
- Aplique um filtro pequeno e representativo para a validação inicial.
- Abra Map columns, revise os campos incluídos e configure o mascaramento das colunas escolhidas que não são chave.
- Escolha o modo de sincronia e o tamanho de página pensando no efeito no destino.
- Execute a operação e inspecione o estado final, os avisos e amostras do destino.
- Valide as referências, as substituições esperadas, as colunas obrigatórias e os valores únicos.
- Salve a configuração e revise a representação do job antes de agendar uma execução recorrente.
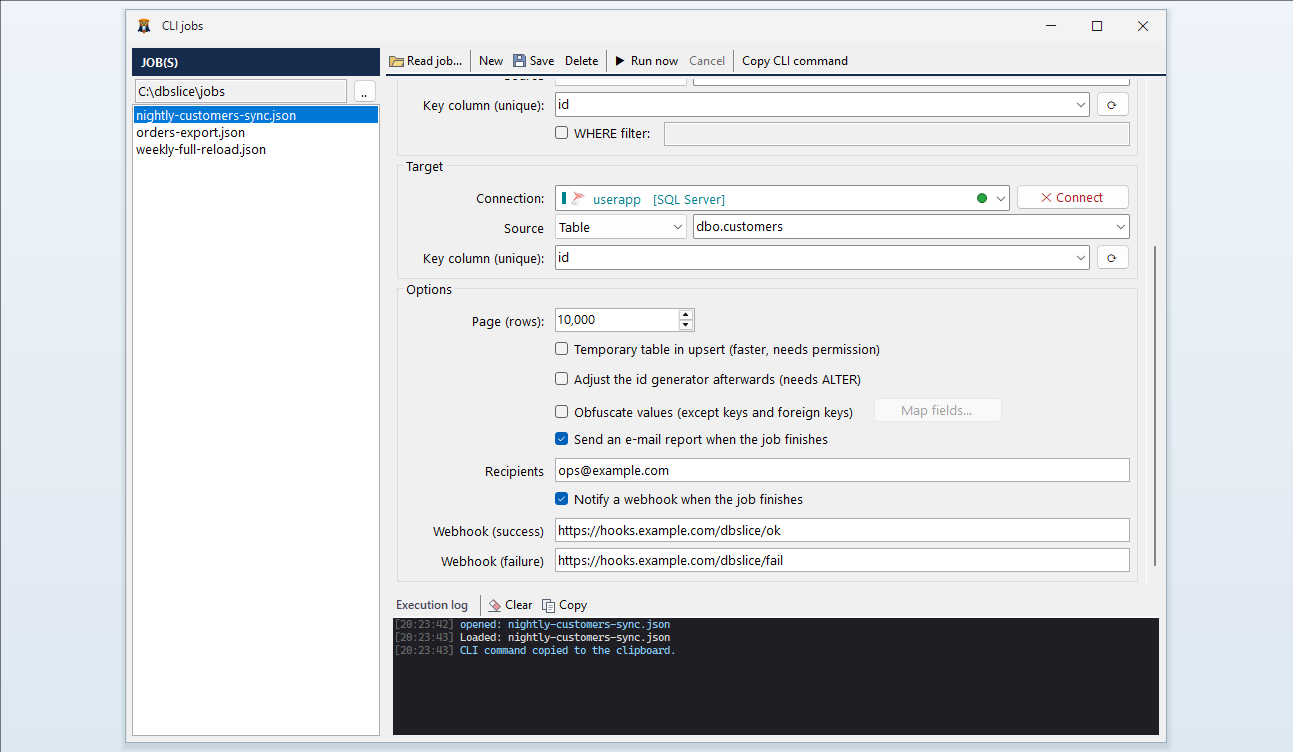
Não suponha que as regras de mapeamento da interface e a opção ampla de ofuscação de um job expressam a mesma política. Confirme que uma configuração salva ou exportada leva os mapeamentos de colunas e as regras de que aquele fluxo específico precisa. Inspecione o job gerado, em vez de inventar à mão propriedades JSON não suportadas.
A CLI permite que jobs salvos adequados rodem sem a interface interativa. Use os recursos de geração de comando do aplicativo para a versão instalada, e depois configure a identidade, o acesso, o tratamento de falhas e a política de sobreposição do agendador externo.
Publicar registros no Apache Kafka e em outros brokers de mensagens faz parte do dbSlice 2.3, pela aba Send Data, descrita no guia do Send Data. Serviços Linux, implantação em Docker e pipelines de agendamento sob medida, mostrados como opções de consultoria no material fornecido, devem ser tratados como trabalho de integração à parte. Não devem ser apresentados como componentes incluídos automaticamente no aplicativo desktop Windows.
10. Valide o resultado transformado, não só a contagem de linhas
Uma contagem de linhas que bate é útil, mas não prova que os dados certos chegaram nem que o mascaramento foi aplicado corretamente.
| Verificação | O que ela comprova |
|---|---|
| Chaves e escopo escolhido | Os registros esperados chegaram ao destino. |
| Referências pai-filho | A fatia continua utilizável entre as tabelas dependentes. |
| Valores mapeados e tipos | Os campos chegaram às colunas pretendidas com representações válidas. |
| Amostras mascaradas | As regras explícitas produziram as substituições esperadas. |
| Campos únicos e obrigatórios | As substituições não quebraram as restrições da aplicação. |
| Linhas do destino fora do escopo | Uma atualização não deixou um resíduo sem gestão. |
| Registros de conclusão e de recuperação | A operação deu certo ou tem um estado de recuperação compreendido. |
Para uma coluna mascarada, compare o destino com o valor transformado esperado, não com o valor original da origem. Uma comparação dos valores brutos deve acusar diferença ali. Separe essas diferenças intencionais dos registros que faltam e das mudanças inesperadas de mapeamento.
Na demonstração anterior fornecida, um Upsert de SQL Server para PostgreSQL processou 245.014 registros de serviço em 10,6 segundos. Uma execução por job salvo informou 10,7 segundos. Essas observações ilustram uma carga de transferência específica. Elas não estabelecem o custo do mascaramento, a latência de CDC, o desempenho de uma frota de SQLite nem uma garantia de segurança de ponta a ponta. O contador combinado upsert/update também não prova sozinho quantos valores já gravados realmente mudaram.
11. Comece com uma atualização controlada
Uma boa primeira implantação é uma atualização pequena e repetível, com propósito claro: uma fatia de teste representativa, uma tabela de integração ou um catálogo local. Defina o subconjunto, mapeie as colunas, especifique as regras de mascaramento, confira o destino e registre como a operação será repetida e recuperada.
Esse é o valor central do dbSlice neste fluxo: tornar a movimentação de dados configurável e inspecionável, colocando a transformação antes das gravações no destino. Aumente o volume, a agenda e o número de consumidores depois que o comportamento estiver validado para o ambiente pretendido.
Conheça o produto e as opções de instalação em dbslice.net.
Guia relacionado: Sincronizar um banco de produção em uso sem travá-lo.
Fontes e escopo
Este artigo desenvolve os temas de sincronia, mascaramento e entrega das ilustrações fornecidas. Os detalhes específicos do produto foram conferidos com a implementação que acompanha o material: SyncService, ColumnMappingForm, ObfuscationScope e ObfuscationMask. Os números de tentativas, as condições dos pontos de controle e as regras de mascaramento são observações da implementação e podem mudar entre versões.
Referências externas: visão geral do produto dbSlice e terminologia do EDPB sobre anonimização e pseudonimização. Os diagramas deste artigo são esquemas explicativos, não a afirmação de que uma implantação com vários nós foi executada. Todos os exemplos de mascaramento usam valores sintéticos. Nenhuma transferência em banco em uso foi feita para escrever este artigo.