Em um ambiente comum: 31,4 milhões de linhas para o Azure SQL em cerca de 30 minutos (≈17.200 linhas/s). Modo de carga inicial, origem SQLite em disco local, app desktop do dbSlice, setembro de 2026 — antes das otimizações de setembro e outubro.
A vazão depende do volume, da rede, dos bancos, da largura da linha, dos ajustes e das transformações. Os seus números vão ser outros — teste com os seus dados na versão gratuita.
De onde vem a velocidade
- Paginação por chave. O dbSlice lê a origem página a página, pela chave, sem cursor longo e sem travar a tabela — por isso pode rodar contra um sistema em uso.
- Leitura e gravação ao mesmo tempo. Ler a próxima página e gravar a anterior acontecem juntos; o lado mais lento dita o ritmo.
- Carga em lote nativa. Onde o banco tem uma, o dbSlice usa — por exemplo, o SqlBulkCopy no SQL Server.
Cópias PostgreSQL em dia
Com a opção upsert por tabela temporária ligada, o upsert e o "só linhas novas" para o PostgreSQL ficaram de 66 a 118 vezes mais rápidos no dbSlice 2.3.20261016: 10.000 linhas passaram de 425 para cerca de 28.000 linhas/s, e repor 1 milhão de linhas faltantes caiu de 21 minutos para 10,6 segundos.
Medido no nosso laboratório: SQL Server 2022 → PostgreSQL 17 no mesmo host, sem outra carga, uma execução por caso. A opção vem desligada e precisa de permissão para criar tabela temporária no destino. Carga inicial, recarga completa e "só atualizar" não mudaram.
O mesmo motor em todo lugar
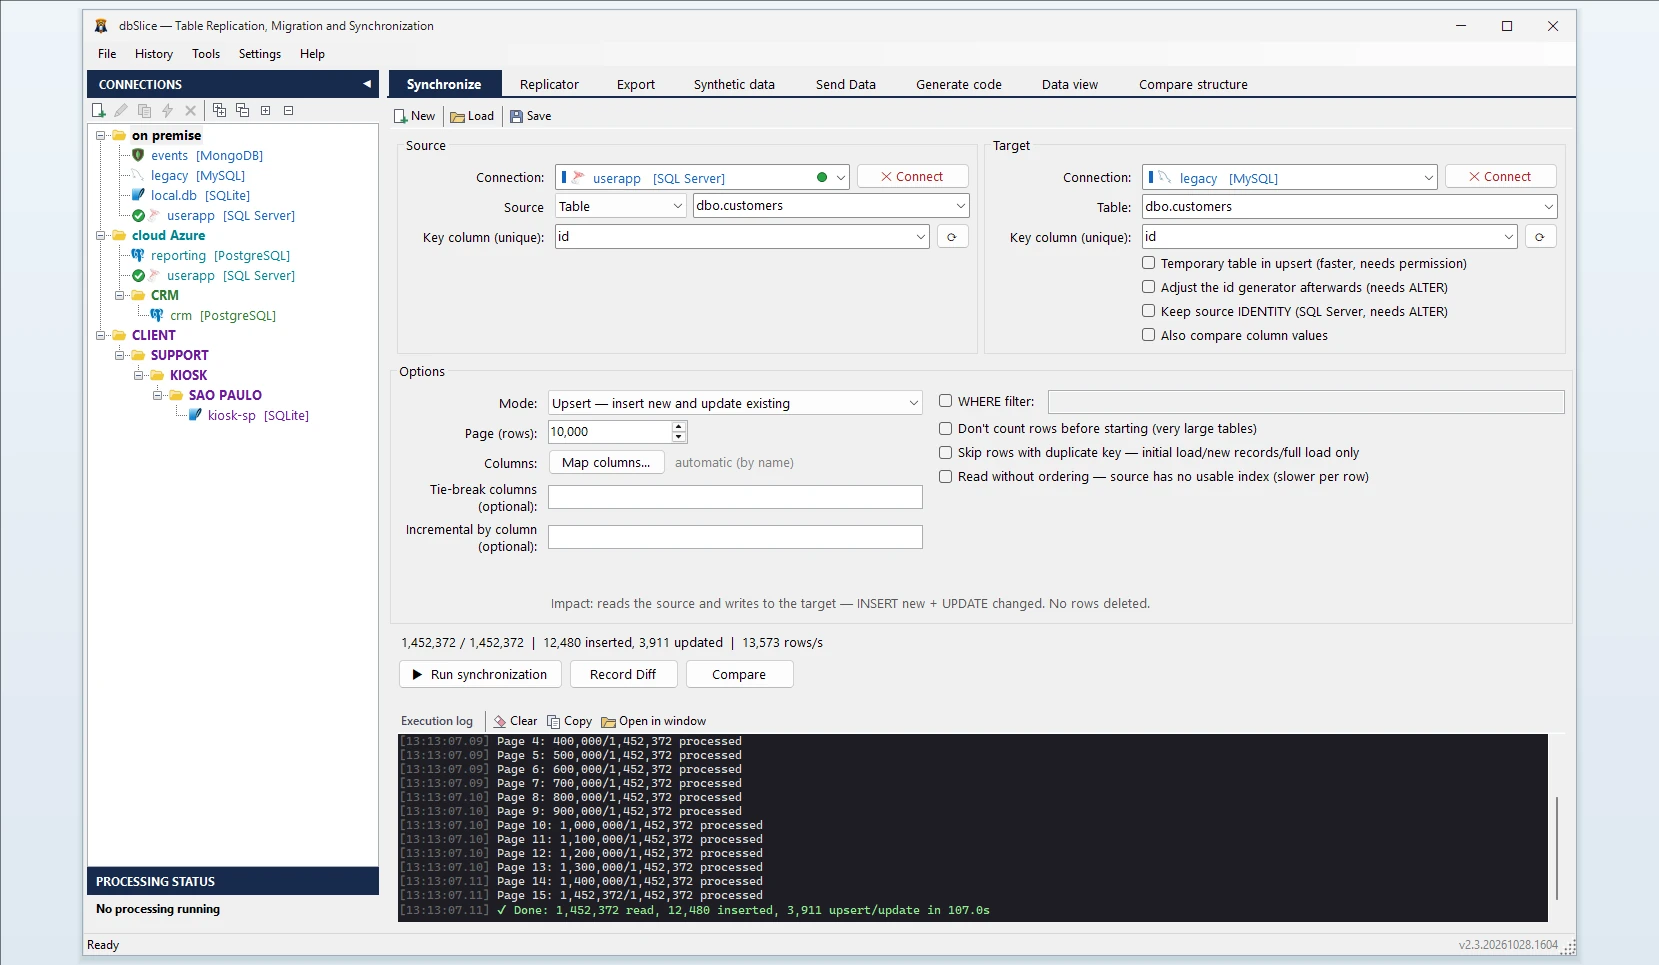
A aba Sincronizar, o Replicator e os jobs de linha de comando rodam no mesmo motor: uma execução que você cronometra na tela se comporta igual quando roda de madrugada, agendada.
Meça você mesmo
Rode o mesmo job nas suas tabelas. Versão gratuita na Microsoft Store · Preços
Leia mais no blog: 12,96 bilhões de linhas em 41 horas, e as condições por trás · Como ler um número de velocidade de sincronização