
Notas de laboratório e capturas: dbSlice 2.3 · Público: desenvolvedores, DBAs, engenheiros de DevOps e SREs
Mover uma tabela entre bancos diferentes é só parte da tarefa. Você também precisa preservar as chaves, respeitar os relacionamentos, escolher como tratar as linhas que já existem e tornar a operação repetível.
Este guia acompanha um banco de vendas de uma origem SQL Server para um destino PostgreSQL. Começamos pela instalação, cadastramos as conexões, rodamos uma sincronia pela tela e transformamos a mesma operação num job salvo que roda pelo PowerShell. O exemplo usa 245.014 registros de serviço de um banco sintético com 2.250.837 registros em 11 tabelas.
O dbSlice é um aplicativo Windows de migração, sincronia e conciliação de dados. Ele tem um fluxo gráfico e jobs salvos que rodam sem abrir a interface principal. Veja a visão geral oficial do produto para os recursos atuais.
Precisa manter os dois sincronizados depois da migração? →
Migração de SQL Server para PostgreSQL: tipos e virada →
A execução registrada copiou a tabela service pelo caminho Upsert em 10,6 segundos. É uma observação deste laboratório, não uma garantia de desempenho nem o resultado de uma migração de banco inteiro.
1. Instale o dbSlice
Opção A: Microsoft Store
Abra a página do dbSlice na Microsoft Store, confirme que o editor é Thinwork Tecnologia da Informação e escolha a ação de instalação que a Store mostrar. Depois de instalar, abra o dbSlice pelo menu Iniciar do Windows.
O ID do produto é 9PMS69X1T53Z. É também o identificador usado nos comandos do WinGet abaixo. O site oficial aponta para esta página.
Opção B: WinGet
Abra o PowerShell ou o Terminal do Windows e confira se o WinGet está disponível:
winget --version
Se o comando não estiver disponível, instale ou atualize o App Installer da Microsoft. O WinGet é distribuído com o App Installer nos sistemas Windows desktop suportados. Veja a documentação do WinGet da Microsoft.
Inspecione o pacote e depois instale a partir da fonte Microsoft Store:
winget show --id 9PMS69X1T53Z --source msstore
winget install --id 9PMS69X1T53Z --source msstore
Revise os contratos de fonte ou de pacote que o WinGet mostrar. Usar o ID do produto escolhe diretamente o pacote pretendido. A opção --source msstore escolhe o catálogo da Store; este guia não depende do nome de um pacote num repositório comunitário à parte. A Microsoft documenta a escolha por identificador e a escolha de fonte na referência do winget install.
Se uma busca pelo nome não encontrar o produto, use o link direto da Store ou inspecione o ID do produto acima. Se o WinGet acusar um erro de certificado ou de rede, resolva esse problema de conexão antes de tentar de novo.
Ativação e o escopo deste passo a passo
O site oficial descreve uma avaliação na Store com recursos limitados. Para ativar uma licença comprada, abra Ajuda → Sobre o dbSlice, informe o e-mail da compra e o código de ativação e clique em Ativar. O FAQ atual diz que o uso pela linha de comando exige manutenção ativa. Use uma instalação ativada e elegível para o job com o volume completo deste artigo; não suponha que a avaliação reproduz esta carga. Consulte o FAQ atual de licenciamento e ativação.
As capturas do aplicativo fornecidas mostram o dbSlice 2.3. As referências do site e da instalação foram conferidas quando o laboratório foi registrado. Os rótulos e a disponibilidade podem mudar em versões posteriores.
2. Entenda o laboratório
O banco lógico se chama db_vendas. Os nomes das tabelas e das colunas estão em inglês. MASTER é o nome de um perfil de conexão da origem; ele não é o banco de sistema do SQL Server chamado master.
| Perfil de conexão | Banco | Papel | Nome do objeto |
|---|---|---|---|
MASTER |
SQL Server | Origem com dados | dbo.service |
Server-dbPostg |
PostgreSQL | Destino principal deste guia | public.service |
Server-dbMaria |
MariaDB | Destino adicional preparado | service em db_vendas |
Server-dbLite |
SQLite | Destino adicional preparado | service num arquivo local |
Todos os perfis pertencem ao ambiente article. Endereços reais de servidor, usuários de banco e senhas ficaram de fora do artigo e dos jobs de exemplo de propósito. Informe esses valores localmente ao criar os perfis de conexão.
A preparação inicial criou esquemas de destino vazios. Quando a sincronia começa, esses destinos deixam de estar vazios. Os logs de tempo, sozinhos, não estabelecem o conteúdo exato de cada destino antes de cada execução.
Conjunto de dados e relacionamentos
| Tabela | Linhas na origem | Propósito |
|---|---|---|
company |
25 | Empresas |
permission |
8 | Perfis de permissão dos usuários |
entity_type |
6 | Tipos de classificação compartilhados |
category |
120 | Categorias de itens e de serviços |
app_user |
250 | Usuários da aplicação |
person |
20,423 | Registros de clientes/pessoas |
item |
11,172 | Catálogo de itens |
service |
245,014 | Catálogo de serviços |
item_service |
402,780 | Associações entre itens e serviços |
sale |
550,023 | Cabeçalhos de venda |
sale_item |
1,021,016 | Itens de venda |
| Total | 2,250,837 | 11 tabelas relacionadas |
O modelo tem 11 chaves primárias, 14 chaves estrangeiras, 12 constraints de unicidade e 14 índices secundários definidos de forma explícita. Os IDs vêm da origem, e não são gerados por colunas identity. Os dados são sintéticos; os e-mails de exemplo usam example.invalid.
No exemplo dos serviços, a cadeia de dependências é:
entity_type → category → service
Carregue entity_type e category antes de service, para as chaves estrangeiras dela poderem ser satisfeitas. Uma sincronia no nível da tabela não promete copiar automaticamente as tabelas dependentes.
Para uma carga inicial completa deste modelo com as chaves estrangeiras ativas, use:
company → permission → entity_type → category → app_user → person
        → item → service → item_service → sale → sale_item
Esta é uma ordem de inserção válida, não a afirmação de que toda tabela vizinha tem relação direta. Os scripts de esquema e de carga estão na pasta sql/ que acompanha o guia. Só o SQL Server recebe os dados sintéticos; os outros scripts criam estruturas vazias. O script de carga do SQL Server exige que todas as tabelas da demonstração estejam vazias.
3. Cadastre e teste as conexões
Use File → New Connection para criar cada perfil de conexão. Escolha o ambiente article, escolha o banco e informe os dados de conexão locais.
Para a origem, use o nome de perfil MASTER, o tipo de banco SQL Server e o banco da aplicação db_vendas. Para o destino, use Server-dbPostg, o tipo PostgreSQL e db_vendas. Clique em Test connection antes de salvar cada perfil.
Para o MariaDB, escolha MariaDB e informe uma conta que acesse as tabelas de destino preparadas. Um banco visível para um administrador pode continuar inacessível para outra conta. Para o SQLite, escolha SQLite e use o campo Database / File para escolher o arquivo .db preparado; este arquivo de laboratório não precisa de login de servidor.
A conta da origem precisa de acesso de leitura. A conta do destino precisa do acesso adequado à operação escolhida, como inserir e atualizar linhas no Upsert. Criar tabelas que faltam no destino também exige privilégios de DDL. Este laboratório usa esquemas criados antes.
4. Rode a primeira sincronia pela interface
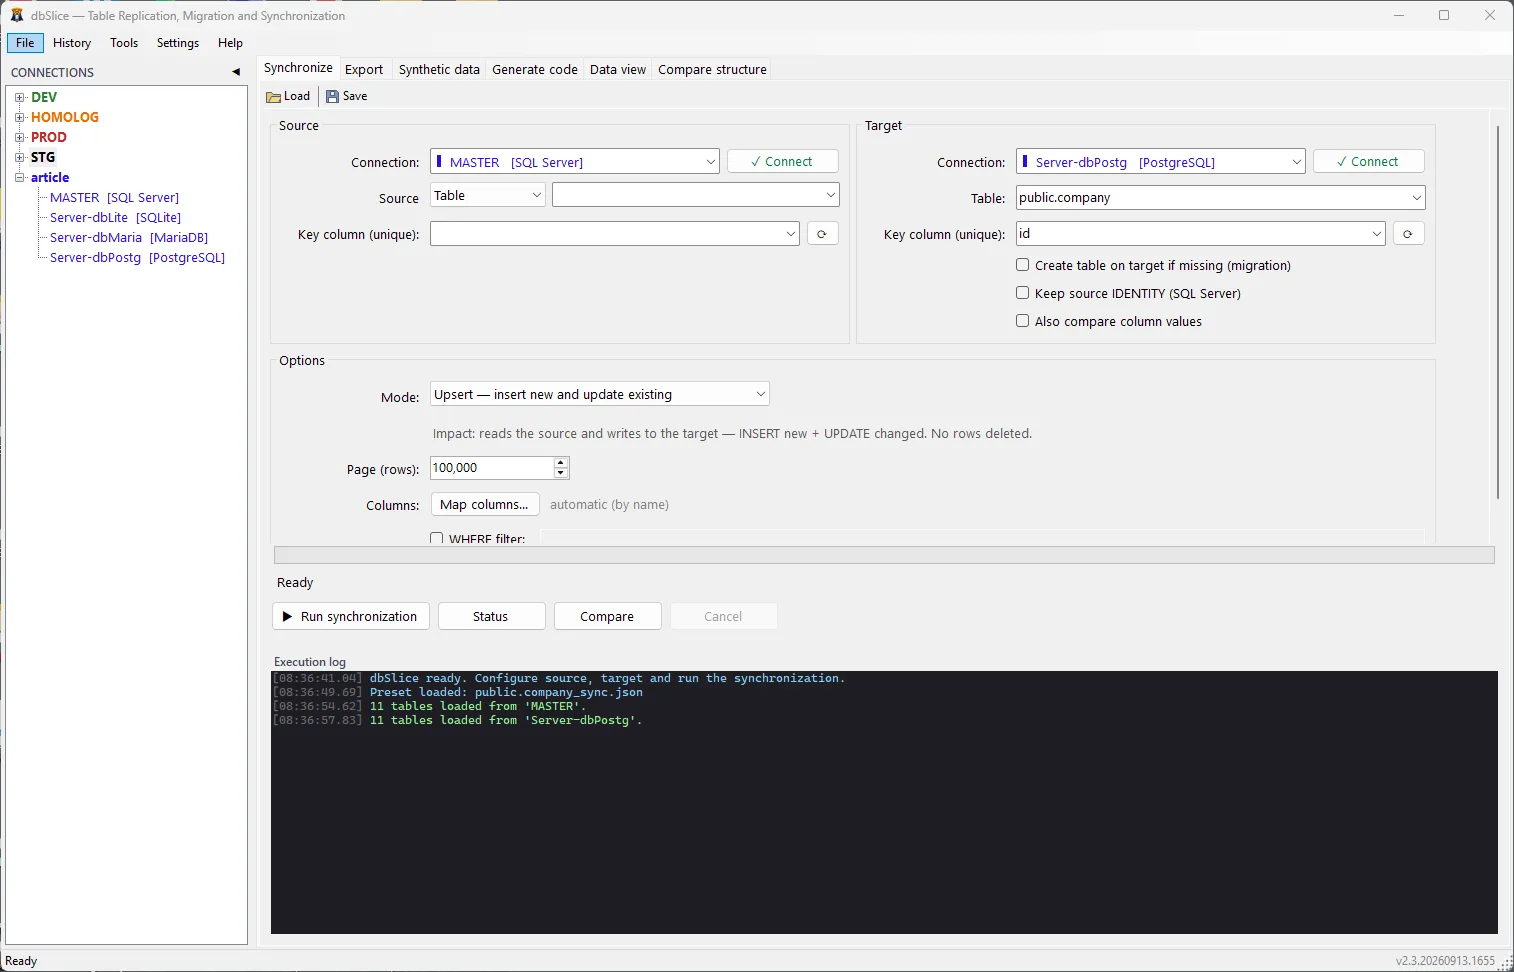
Comece pela tabela pequena company para conferir o fluxo de ponta a ponta. Depois carregue as dependências de que service precisa.
- Abra a aba Synchronize.
- Em Source, escolha
MASTERe clique em Connect. - Ponha o tipo de origem em Table, escolha
companye escolhaidem Key column (unique). - Em Target, escolha
Server-dbPostge clique em Connect. - Escolha
public.companye a chave de destinoid. - Escolha Upsert — insert new and update existing.
- Inspecione o Map columns…. Os nomes iguais permitem o mapeamento automático usado neste laboratório.
- Clique em Run synchronization e inspecione o log de execução.
A captura de company fornecida informa 25 linhas lidas e 25 no contador combinado upsert/update. A duração mostrada é de 0,1 segundo. Use isso como um teste de conexão, e não como um benchmark de vazão significativo.
Configure a execução maior, de serviços
Depois de carregar os registros de categoria/tipo necessários, use estas configurações:
| Configuração | Valor |
|---|---|
| Conexão de origem | MASTER |
| Tabela de origem | service (esquema dbo do SQL Server) |
| Chave de origem | id |
| Conexão de destino | Server-dbPostg |
| Tabela de destino | public.service |
| Chave de destino | id |
| Modo | Upsert — insert new and update existing |
| Page (rows) | 100,000 |
| Colunas | Casar pelo nome; revise o mapeamento |
| Filtro WHERE | Desligado, para a tabela completa |
| Create table on target if missing | Desmarcado: o destino já existe |
| Keep source IDENTITY | Desmarcado: este modelo não tem colunas identity |
Com 245.014 linhas na origem e um tamanho de página de 100.000, o progresso esperado é 100.000, 200.000 e 245.014 processadas. O tamanho de página é uma configuração de processamento do aplicativo; ele não deve ser interpretado como o número exato de comandos SQL ou de requisições de rede.
Escolha o comportamento de gravação de propósito
| Modo | Comportamento pretendido | Uso adequado |
|---|---|---|
| Upsert | Inserir as chaves ausentes e atualizar as correspondentes; manter as linhas que só existem no destino | Sincronia repetível |
| Update Only | Atualizar as chaves correspondentes; não inserir as ausentes | Atualizar as linhas que já estão lá |
| Insert New | Inserir as chaves que faltam no destino | Inclusões sem atualizar as linhas existentes |
| Insert Only | Tentar inserir todas as linhas escolhidas | Carga inicial num destino vazio e compatível |
| Force Load | Esvaziar e recarregar o destino | Substituição explícita de um destino descartável |
Este passo a passo usa Upsert e Update Only. O Upsert não exclui as linhas que só existem no destino; então, sozinho, não estabelece uma réplica exata. O Update Only não preenche um destino vazio. O Force Load muda a operação para substituição e pode ser incompatível com chaves estrangeiras que referenciam a tabela; ele não é usado aqui.
5. Leia corretamente os resultados da interface
O log do Upsert fornecido registra:
[09:07:34.95] Starting: MASTER.service -> Server-dbPostg.public.service
             [Upsert — insert new and update existing]
[09:07:35.06] Source total: 245,014 rows
[09:07:39.49] Page 1: 100,000/245,014 processed
[09:07:43.74] Page 2: 200,000/245,014 processed
[09:07:45.56] Page 3: 245,014/245,014 processed
[09:07:45.57] Done: 245,014 read, 0 inserted, 245,014 upsert/update in 10.6s
             read 0.5s / transform 0.2s / write 10.2s
A execução seguinte, de Update Only, registra:
[09:07:51.81] Starting: MASTER.service -> Server-dbPostg.public.service
             [Update existing only (UPDATE)]
[09:07:51.88] Source total: 245,014 rows
[09:08:38.85] Page 1: 100,000/245,014 processed
[09:09:24.73] Page 2: 200,000/245,014 processed
[09:09:44.34] Page 3: 245,014/245,014 processed
[09:09:44.36] Done: 245,014 read, 0 inserted, 245,014 upsert/update in 112.5s
             read 0.6s / transform 0.4s / write 111.9s
Os trechos preservam as medições informadas; as linhas de conclusão repetidas foram omitidas e as linhas longas foram quebradas para facilitar a leitura.
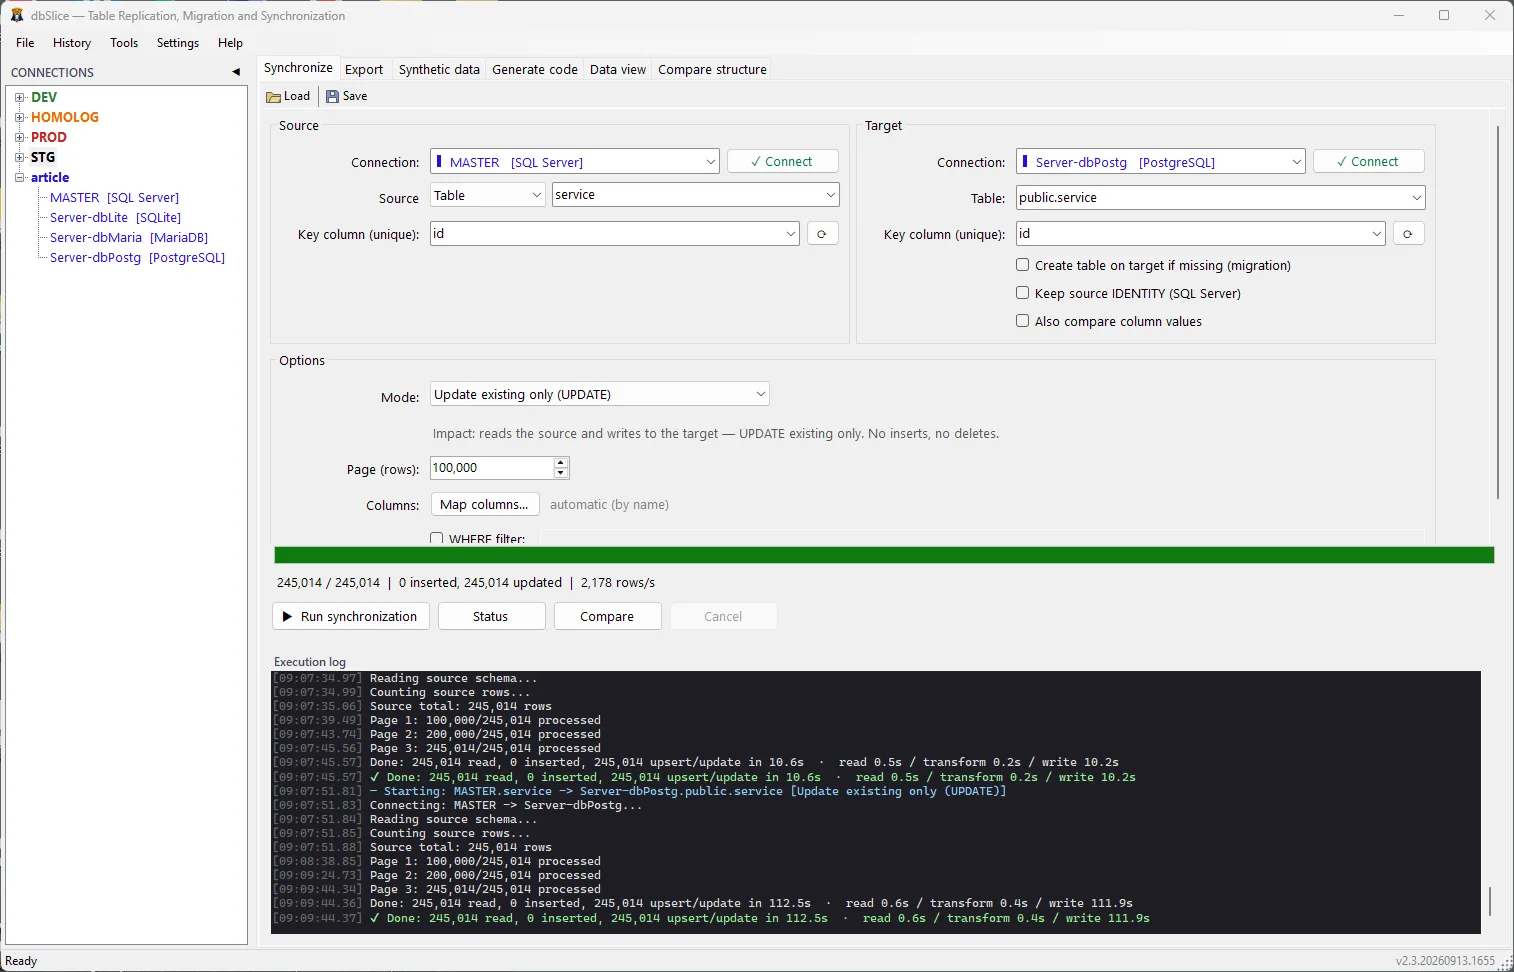
O contador combinado importa. Na implementação revisada para este artigo, as gravações do Upsert se acumulam no contador upsert/update. Elas não são divididas em inclusões e atualizações medidas separadamente. Por isso, 0 inserted num resumo de Upsert não prova que nenhuma linha nova foi inserida, e 245,014 upsert/update não prova que 245.014 linhas que já existiam mudaram de valor. Trate isso como progresso operacional e valide o destino à parte.
Os tempos por etapa também são diferentes do tempo decorrido no relógio. A leitura pode se sobrepor ao processamento e à gravação, e os valores informados são arredondados. Não some read, transform e write para reconstruir a duração total.
6. Salve a operação como job
Abra Tools → CLI jobs e escolha New. Configure:
| Campo do job | Valor |
|---|---|
| Name | Transf_PostgreSQL_dbstoreSite |
| Type | Sync — source to target, choose the mode |
| Sync mode | Upsert |
| Conexão / tabela / chave de origem | MASTER / service / id |
| Conexão / tabela / chave de destino | Server-dbPostg / public.service / id |
| Page (rows) | 10,000 |
| WHERE filter | Desligado |
Clique em Save e use Run now para executar o job salvo pelo editor. Isso é diferente de abrir a CLI avulsa num terminal.
O log do editor de jobs fornecido mostra 25 páginas: 24 páginas de 10.000 linhas e depois 5.014 linhas. A conclusão dele é:
[09:18:33] --- Transf_PostgreSQL_dbstoreSite (Sync · Upsert) ---
[09:18:33] source : MASTER [SQL Server] · service · key: id
[09:18:33] target: Server-dbPostg [PostgreSQL] · public.service · mode: Upsert
[09:18:33] impact: writes to the target (INSERT + UPDATE)
...
[09:18:44] Page 25: 245,014/245,014 processed
[09:18:44] OK Done: 245,014 read, 0 inserted, 245,014 upsert/update in 10.7s
           read 0.8s / transform 0.3s / write 10.2s
[09:18:44] Sync OK | MASTER -> Server-dbPostg | 245,014 Rows | 10.7s
Clique em Copy CLI command para obter o comando do arquivo salvo. Um job se refere aos perfis de conexão guardados pelo ambiente e pelo nome; nenhuma senha de banco é necessária no JSON do job.
O arquivo service-upsert.job.json que acompanha o guia expressa a mesma configuração. Os nomes dos campos seguem o formato de arquivo atual do dbSlice, inclusive nome, tipo, origem e destino. São identificadores de API/esquema e não podem ser traduzidos nem alterados.
{
  "nome": "Transf_PostgreSQL_dbstoreSite",
  "tipo": "Sync",
  "mode": "Upsert",
  "origem": {
    "environment": "article",
    "db": "MASTER",
    "type": "TABLE",
    "object": "service",
    "key": "id"
  },
  "destino": {
    "environment": "article",
    "db": "Server-dbPostg",
    "type": "TABLE",
    "object": "public.service",
    "key": "id"
  },
  "pageSize": 10000,
  "createTargetIfMissing": false,
  "ofuscar": false,
  "alertemail": false
}
Os nomes precisam bater com os perfis salvos no usuário do Windows que roda o job. O objeto de origem é service, como nas capturas; use o nome qualificado pelo esquema se o esquema padrão do seu usuário de banco exigir.
7. Rode o job pelo PowerShell
O formato da linha de comando é posicional:
dbSlice <job.json> [job.log]
O segundo argumento, opcional, grava um log com data e hora. Esse arquivo é recriado a cada execução; então dê a cada execução um nome de log diferente se precisar do histórico.
Primeiro, localize o executável. Se o dbSlice.exe já estiver disponível pelo caminho de comandos, use-o. Numa instalação pela Store, o trecho a seguir encontra o pacote do aplicativo instalado para o usuário atual do Windows, sem fixar o diretório de instalação, que muda com a versão:
$command = Get-Command dbSlice.exe -ErrorAction SilentlyContinue
if ($command) {
    $dbSliceExe = $command.Source
} else {
    $package = Get-AppxPackage -Name '*dbslice*' |
        Where-Object { Test-Path (Join-Path $_.InstallLocation 'dbSlice.exe') } |
        Select-Object -First 1
    if (-not $package) {
        throw 'Locate your installed dbSlice.exe and set $dbSliceExe to its full path.'
    }
    $dbSliceExe = Join-Path $package.InstallLocation 'dbSlice.exe'
}
Não suponha que a instalação acrescenta automaticamente um alias no shell. Você também pode definir $dbSliceExe explicitamente com o executável instalado. Confira --help e --version ao verificar outra versão.
A partir da pasta deste artigo, rode o script que acompanha o guia:
.\examples\Invoke-ServiceSync.ps1 -DbSliceExe $dbSliceExe
O script espera o executável, que é de interface gráfica, terminar, cria um log separado para cada execução e devolve o código de saída dele. Ele chama a CLI existente; não cria conexões, não concede permissões e não preenche tabelas pré-requisito.
Para rodar um job salvo pelo editor gráfico, passe o caminho dele de forma explícita:
$savedJob = Join-Path $env:APPDATA 'dbSlice\jobs\Transf_PostgreSQL_dbstoreSite_job.json'
.\examples\Invoke-ServiceSync.ps1 -DbSliceExe $dbSliceExe -JobPath $savedJob
Na captura do terminal fornecida, a CLI avulsa processa as mesmas 245.014 linhas em 13,8 segundos. O relatório por etapa é read 0.8s / transform 0.2s / write 9.9s. É uma execução diferente da de 10,7 segundos no editor de jobs.
| Código de saída | Significado na CLI revisada |
|---|---|
0 |
O job terminou com sucesso |
1 |
A execução do job falhou |
2 |
Os argumentos, a leitura do arquivo do job ou a elegibilidade da licença impediram a execução |
Para agendar, rode com uma conta do Windows que tenha acesso aos perfis salvos do aplicativo e à licença adequada. Um arquivo JSON copiado, sozinho, não transfere as credenciais a que ele se refere. Defina o diretório de trabalho da tarefa e use caminhos absolutos para o executável e o job. O script de exemplo tem um parâmetro -LogDirectory para guardar os logs operacionais.
8. Compare as execuções observadas
As quatro medições abaixo se referem a service, com 245.014 linhas lidas do SQL Server e o PostgreSQL como destino.
| Execução | Modo | Tamanho de página | Páginas | Decorrido | Linhas/s aprox. |
|---|---|---|---|---|---|
| Aba Synchronize | Upsert | 100,000 | 3 | 10,6 s | 23,115 |
| Aba Synchronize | Update Only | 100,000 | 3 | 112,5 s | 2,178 |
| Editor CLI jobs, Run now | Upsert | 10,000 | 25 | 10,7 s | 22,899 |
| Execução avulsa no terminal | Upsert | 10,000 | 25 | 8,9 s | 26,213 |
A vazão é calculada como 245.014 / segundos decorridos informados e arredondada para a linha inteira mais próxima. As entradas já são durações arredondadas.

A execução de Update Only pela interface levou cerca de 10,6 vezes mais que a de Upsert pela interface. Isso não significa que o Upsert seja sempre mais rápido, nem que os dois modos sejam intercambiáveis. Eles têm semânticas de gravação diferentes. O hardware, as versões dos bancos, a latência de rede, a carga dos servidores, o estado do cache e o conteúdo dos destinos não foram registrados como especificação de um benchmark controlado. Os dois tamanhos de página também não foram testados em repetições controladas.
O resultado sustenta uma conclusão mais estreita: a execução fornecida concluiu uma operação Upsert de 245.014 linhas em 10,6 segundos, e o fluxo de job salvo repetiu a operação com sucesso tanto pelo editor de jobs quanto pelo terminal.
Com a opção de upsert por tabela temporária ligada, os modos Upsert e New rows only rodam cerca de 66 a 118 vezes mais rápido para destinos PostgreSQL do que sem ela, no laboratório de desenvolvimento: uma carga de 10.000 linhas passa de 425 para cerca de 28.000 linhas por segundo, e a restauração de uma tabela de 1 milhão de linhas, de 21 minutos para 10,6 segundos. O Initial load e o Full load não são afetados. Depois de uma cópia que mantém os ids da origem, a sequence da coluna no PostgreSQL também avança até o maior id; assim, o próximo registro criado pela sua aplicação não colide com um copiado. Esses números foram medidos com o PostgreSQL no mesmo host e sem outra carga; não são garantia, e uma rede, um esquema maior ou outras cargas os mudam. As execuções registradas neste artigo são individuais, em outro laboratório; então não as compare com os números acima. Repita a execução no seu ambiente antes de planejar uma janela.
9. Valide o destino
Um log de sucesso é o ponto de partida da conferência. Rode as consultas a seguir nos clientes de banco adequados depois de uma sincronia da tabela de serviços completa.
Origem SQL Server:
SELECT COUNT_BIG(*) AS row_count, MIN(id) AS first_id, MAX(id) AS last_id
FROM dbo.service;
Destino PostgreSQL:
SELECT COUNT(*) AS row_count, MIN(id) AS first_id, MAX(id) AS last_id
FROM public.service;

SELECT COUNT(*) AS orphan_services
FROM public.service AS s
LEFT JOIN public.category AS c ON c.id = s.category_id
WHERE c.id IS NULL;
Para o conjunto sintético de serviços sem filtro e sem registros que só existem no destino, espere 245.014 linhas, IDs de 1 a 245.014 e zero serviços órfãos. As conferências de contagem/mínimo/máximo são úteis, mas não provam que todos os valores batem.
Use o recurso Compare do dbSlice para examinar as diferenças de chave, e ligue Also compare column values ao validar o conteúdo. Inspecione os mapeamentos de colunas configurados e revise as diferenças. Lembre que uma execução Upsert mantém de propósito as linhas que só existem no destino.
Para demonstrar uma fatia de dados depois, ligue o WHERE filter da origem e use uma expressão como category_id = 1. Inclua os registros pais necessários no destino e valide o conjunto filtrado, em vez de esperar a contagem da tabela completa. Documente cada tabela incluída na fatia.
10. Estenda o fluxo para MariaDB e SQLite
Use a conexão MariaDB ou SQLite preparada como destino, escolha a tabela de destino correspondente e a chave id, e revise o mapeamento de colunas. Mantenha a mesma ordem de dependências ao carregar um espelho vazio.
As estruturas do MariaDB e do SQLite estão prontas para esses exercícios, mas a evidência de desempenho fornecida cobre só SQL Server → PostgreSQL. Nenhum tempo dos outros bancos é afirmado aqui.
No SQLite, a verificação de chaves estrangeiras é uma configuração da conexão. Garanta que a conexão usada para copiar e validar a ative. A afinidade numérica do SQLite também é diferente dos tipos decimais de precisão fixa dos bancos servidores; valide os valores monetários com a precisão que o seu cenário exige.
Solução de problemas do passo a passo
| Sintoma | Confira |
|---|---|
| Um campo obrigatório está destacado | Escolha os dois nomes de tabela e as duas chaves únicas antes de rodar |
| O PostgreSQL recusa uma chave estrangeira | Carregue primeiro os registros de tipo/categoria referenciados |
| O MariaDB acusa acesso negado ao banco | Confira os privilégios da conta e do host que de fato conectam |
| A CLI não encontra um perfil | Faça bater environment e db, e rode com a conta do Windows esperada |
dbSlice não é reconhecido no terminal |
Encontre ou informe o caminho completo do executável instalado |
| O job para antes da sincronia | Inspecione o log em busca de erros de arquivo do job, de perfil ou de elegibilidade da licença |
| O Update Only deixa um destino vazio, vazio | Escolha um modo que insere linhas quando a intenção é uma carga inicial |
| As contagens batem, mas os dados podem diferir | Compare as chaves e os valores das colunas; as contagens, sozinhas, não bastam |
Arquivos que acompanham o guia e referências
- Job de Upsert de exemplo: sem strings de conexão nem senhas.
- Script PowerShell: espera a conclusão e preserva o código de saída da CLI.
sql/: scripts de esquema para os quatro bancos e o script de carga sintética do SQL Server.- Site oficial do dbSlice: recursos do produto e ponto de partida da instalação.
- FAQ do dbSlice: ativação e elegibilidade atual de licenciamento.
- Página na Microsoft Store: produto
9PMS69X1T53Z. - Documentação do WinGet da Microsoft: WinGet e App Installer.
- Referência do winget install: opções de ID de pacote e de fonte.
Os resultados numéricos e as ilustrações da interface vêm dos logs e das capturas de laboratório fornecidos. A sintaxe da CLI, os campos do job e a interpretação dos contadores foram conferidos com a implementação local do produto. O artigo não contém credenciais reais, caminhos de perfis pessoais nem endereços de servidores privados.