
Um banco central costuma atender duas cargas muito diferentes: as transações de negócio oficiais e as consultas repetidas a informações relativamente estáveis. Um catálogo de produtos, uma lista de serviços ou uma tabela de classificação pode ser lida milhares de vezes entre uma mudança e outra. Mandar cada consulta pela rede acrescenta trabalho ao banco compartilhado e deixa a aplicação dependente dessa conexão.
Para as cargas adequadas, uma cópia SQLite local pode atender essas leituras enquanto o banco central continua sendo o sistema de registro. O dbSlice oferece um jeito configurável de preparar e atualizar os dados usados por esse modelo de leitura local. A aplicação continua decidindo onde ler, quanta defasagem é aceitável e o que fazer quando uma atualização falha.
Este artigo desenvolve essa arquitetura, explica como ela se encaixa no fluxo do dbSlice e traz uma configuração inicial usando um catálogo de serviços sintético. Ele também mostra como avaliar afirmações de desempenho e de custo contra medições do seu próprio ambiente.
1. O gargalo de leitura central
A pergunta pertinente não é se um banco central é lento por natureza. É se um grupo específico de requisições precisa consultá-lo toda vez.
Pense numa aplicação de filial que carrega repetidamente descrições de serviços e nomes de categorias. Essas leituras dividem a capacidade da rede e os recursos do banco com o lançamento de vendas, as mudanças administrativas e outras aplicações. Levar as consultas ao catálogo para perto de quem as consome pode tirar uma ida e volta pela rede dessas requisições e reduzir a contribuição delas para a carga central.
O benefício depende do gargalo real. Uma aplicação que espera por uma conexão remota pode ganhar de um jeito diferente de outra que gasta a maior parte do tempo avaliando consultas complexas. O bloqueio entre leitura e gravação também depende do banco, do isolamento das transações e do desenho das consultas; não é uma propriedade inevitável de um banco centralizado.
Comece pelas medições: quais consultas se repetem, com que frequência os dados mudam, quanto tempo as requisições passam esperando e quantas leituras toleram uma versão um pouco mais antiga.
2. Modelos de leitura locais com SQLite
O SQLite guarda dados da aplicação localmente e é documentado de forma explícita como um possível cache de dados corporativos. As consultas locais podem evitar chamadas de rede repetidas, e funções escolhidas podem continuar utilizáveis durante uma queda de rede. É um papel complementar ao de um banco central. SQLite: usos adequados
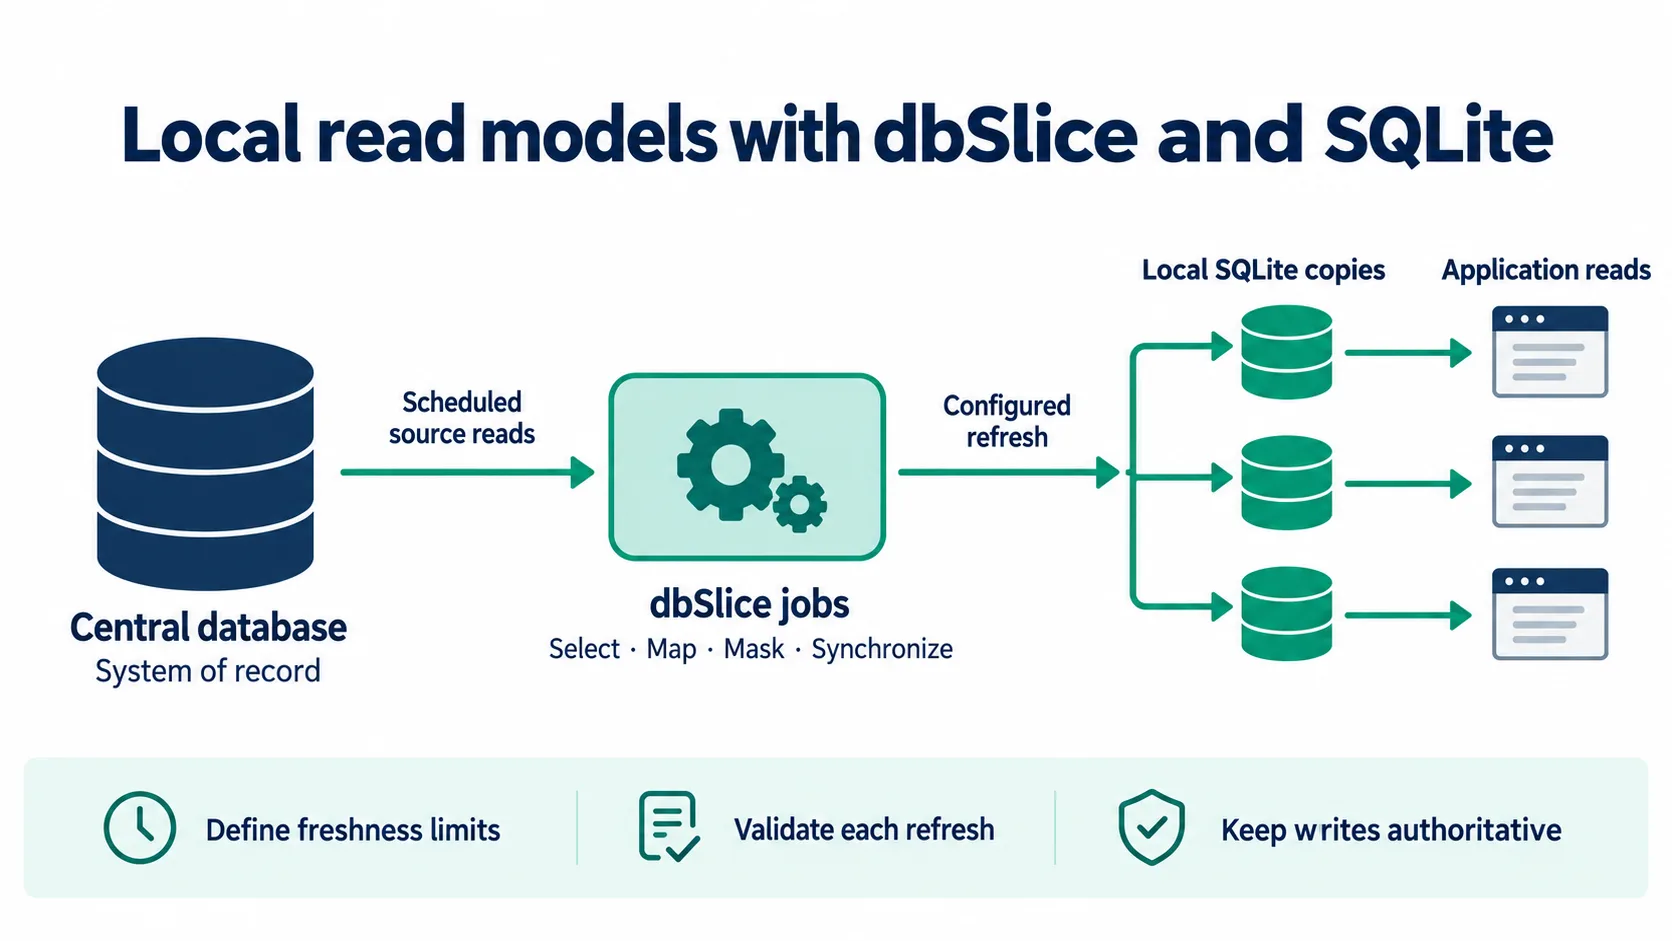
| Responsabilidade | Onde fica |
|---|---|
| Mudanças de negócio oficiais | O banco central e o caminho de gravação da aplicação |
| Escolha de linhas e mapeamento de colunas | A operação configurada no dbSlice |
| Mascaramento, onde for exigido | Regras de transformação configuradas de forma explícita |
| Consultas locais | A aplicação e a sua camada de acesso a dados em SQLite |
| Agendamento dos jobs e distribuição por nó | Automação operacional e ferramentas de implantação |
| Limites de atualidade e comportamento offline | Política da aplicação, monitorada pela operação |
Este desenho não exige que todas as tabelas vão para a ponta. Comece com um domínio pequeno e de regras claras. Mantenha no caminho de gravação oficial as transações que exigem o estado central atual.
Bons candidatos e limites importantes
| Candidato | Por que pode servir | Decisão a tomar |
|---|---|---|
| Descrições de serviços ou produtos | Leituras repetidas, muitas vezes com pouca mudança | Idade máxima do catálogo local |
| Categorias e códigos de referência | Conjuntos compactos com relacionamentos estáveis | Como publicar as tabelas relacionadas de forma coerente |
| Dados de referência de cada filial | Cada filial precisa só de um subconjunto | Como isolar as linhas e incluir as dependências |
| Extratos para relatórios | Consultas repetidas podem usar um modelo local preparado | Agenda de atualização aceitável e conciliação |
| Estoque em tempo real ou autorização financeira | As decisões podem exigir o estado compartilhado atual | Se dados locais são admissíveis, afinal |
O SQLite também tem limites de concorrência. O modo WAL permite que leitores e um gravador trabalhem ao mesmo tempo, mas continua havendo um gravador por vez, e o WAL não foi feito para um banco compartilhado por um sistema de arquivos de rede. Use um arquivo local e valide o padrão de acesso da aplicação. SQLite: write-ahead logging
3. Onde o dbSlice entra
O dbSlice oferece fluxos pela interface e pela CLI para mover dados escolhidos, mapear colunas, aplicar mascaramento e comparar resultados. A lista pública de compatibilidade inclui SQL Server, PostgreSQL, Oracle, MySQL, MariaDB, Firebird, SQLite e Caché/IRIS, mais MongoDB, Cassandra, Elasticsearch, Couchbase e Redis como destino. Visão geral do produto dbSlice
Para um modelo de leitura local, pense no fluxo assim:
Source table, view, or SELECT
    → select the required rows
    → map destination columns
    → apply configured masking, if needed
    → write using the selected synchronization mode
    → compare and validate the result
    → make the validated version available to the application
O passo final de publicação é uma escolha de desenho operacional. Não deve ser confundido com gravar um lote numa tabela de destino.
Um job de atualização é diferente de captura de mudanças
O fluxo descrito aqui usa leituras configuradas de tabelas/consultas e jobs repetíveis. Um Upsert periódico sobre uma origem filtrada não é, por si só, captura de mudanças pelo log de transações nem um fluxo de eventos em tempo real.
Se você precisa extrair só as mudanças, defina primeiro como a origem as identifica: por exemplo, um marcador de atualização confiável ou um feed de mudanças provido à parte. Depois defina como o progresso bem-sucedido é registrado, como as mudanças atrasadas são tratadas e como as exclusões são representadas. Uma chave primária maior, sozinha, não encontra modificações em linhas antigas.
Do mesmo jeito, um ponto de controle de transferência ajuda a recuperar uma execução específica, onde aquele modo é suportado. Ele não deve ser tratado como uma marca permanente de acompanhamento de mudanças entre atualizações sem relação entre si.
4. Desenhe uma fatia de dados útil
O banco de demonstração já tem um catálogo de serviços com 245.014 linhas, junto com categorias, tipos, usuários, empresas e vendas. O conjunto sintético completo tem 2.250.837 registros em 11 tabelas.
Para um modelo de leitura de serviços, comece pela cadeia de dependências:
entity_type → category → service
Use chaves estáveis, preserve os valores das chaves estrangeiras e carregue os registros pais antes dos filhos. Num piloto inicial, copiar por inteiro as pequenas tabelas de tipo e de categoria simplifica o tratamento das dependências. Você pode estreitá-las depois, quando os limites da fatia estiverem definidos.
Por exemplo, um filtro de origem category_id = 1 escolhe uma categoria de serviços. Ele não estabelece, por si só, o isolamento entre clientes; isso depende das regras reais de posse no seu esquema.
Escolha como o modelo local muda
| Modo | Comportamento pertinente a um modelo de leitura local |
|---|---|
| Upsert | Acrescenta as chaves que faltam e atualiza as correspondentes; as linhas que só existem no destino ficam |
| Insert New | Acrescenta as chaves que faltam sem atualizar os valores existentes |
| Update Only | Atualiza as chaves correspondentes, mas não faz o preenchimento inicial |
| Insert Only | Tenta inserir as linhas escolhidas; use com um destino vazio adequado |
| Force Load | Esvazia e recarrega um destino; exige planejamento explícito de dependências e de disponibilidade |
Um Upsert não remove um serviço que foi excluído na origem ou que saiu da categoria escolhida. Decida se vai manter as linhas inativas, conciliar as remoções à parte ou publicar uma versão reconstruída do modelo local. Sem essa decisão, uma fatia pode acumular aos poucos registros que não pertencem mais a ela.
5. Monte um piloto pela interface e pela CLI
Prepare um arquivo SQLite local com o esquema necessário. No dbSlice, cadastre a origem como MASTER e o destino SQLite local como Server-dbLite no ambiente article. Use os seus próprios dados de conexão; eles não fazem parte dos arquivos de job publicados.
Em Synchronize, conecte nos dois perfis, escolha a tabela de origem e a de destino, escolha id como chave e inspecione o mapeamento de colunas. Carregue entity_type, depois category e, por fim, as linhas escolhidas de service.
Os arquivos de job que acompanham o guia expressam essa sequência:
| Arquivo | Objeto de origem e de destino | Filtro |
|---|---|---|
| 01-entity-type.job.json | entity_type |
Nenhum |
| 02-category.job.json | category |
Nenhum |
| 03-service-slice.job.json | service |
category_id = 1 |
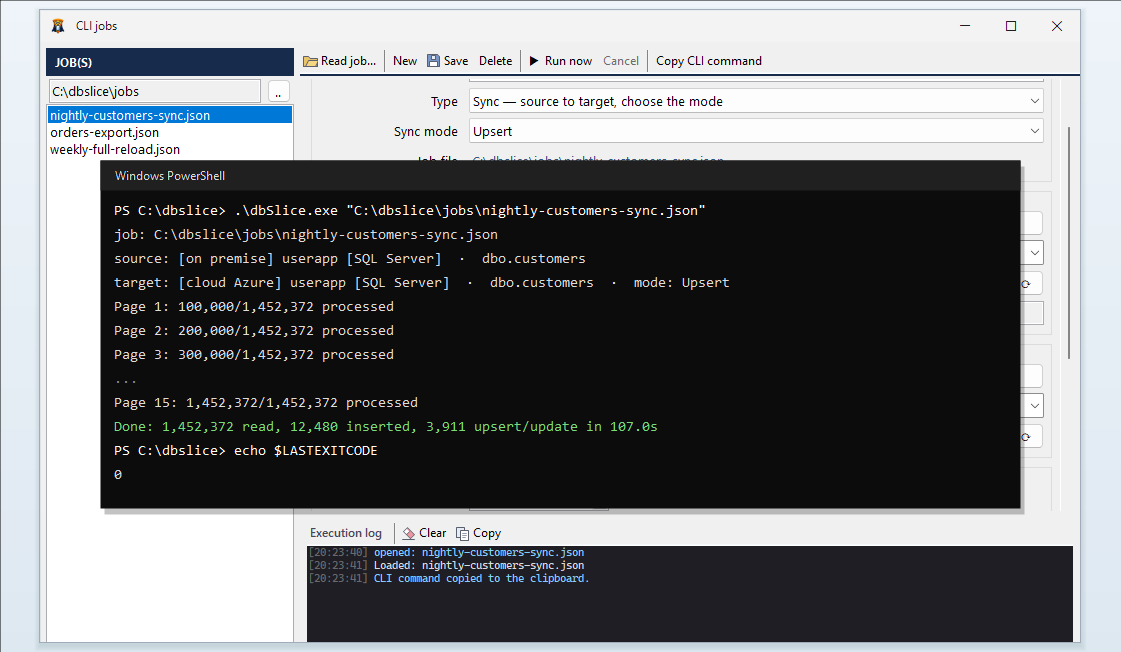
Cada job usa Sync, Upsert e um tamanho de página de 10.000. As tabelas precisam já existir. Os perfis precisam estar disponíveis para a conta do Windows que roda os jobs. São exemplos iniciais para o conjunto sintético, não uma configuração já implantada numa frota.
O job de serviços é:
{
  "nome": "edge-service-category-1",
  "tipo": "Sync",
  "mode": "Upsert",
  "origem": {
    "environment": "article",
    "db": "MASTER",
    "type": "TABLE",
    "object": "service",
    "key": "id",
    "where": "category_id = 1"
  },
  "destino": {
    "environment": "article",
    "db": "Server-dbLite",
    "type": "TABLE",
    "object": "service",
    "key": "id"
  },
  "pageSize": 10000,
  "createTargetIfMissing": false,
  "ofuscar": false,
  "alertemail": false
}
Os nomes dos campos JSON fazem parte do formato de arquivo do produto e não podem mudar. O mascaramento está desligado neste exemplo porque o catálogo de serviços é sintético. Essa configuração não é uma recomendação para transferir dados pessoais.
Use Tools → CLI jobs para ler, revisar e salvar um job, e depois Copy CLI command para obter a chamada. A CLI aceita o caminho do job seguido de um caminho de log opcional:
dbSlice <job.json> [job.log]
Use o caminho completo do executável instalado se o comando não estiver no PATH. No PowerShell ou num agendador, espere cada processo terminar, confira o código de saída e só rode a dependência seguinte depois de um sucesso. Um agendador de tarefas do Windows pode orquestrar a sequência com uma conta que tenha os perfis salvos e a licença necessários.
6. Publique uma versão local coerente
Há duas escolhas comuns de implementação. A certa depende de os leitores tolerarem uma atualização em andamento.
| Estratégia | Benefício | O que você precisa tratar |
|---|---|---|
| Atualizar o banco SQLite ativo | A aplicação continua usando o mesmo arquivo | Disputa pelo gravador e leitores vendo dados de etapas diferentes da atualização |
| Montar e validar uma versão separada | A aplicação pode trocar para um conjunto testado | Gestão de versões, ciclo de vida das conexões e um procedimento explícito de publicação |
Num piloto com tabelas relacionadas, uma versão preparada à parte costuma ser mais fácil de entender. Rode os jobs das dependências, confira chaves e valores e faça a aplicação abrir a versão validada. Guarde a versão válida anterior para recuperação, se o seu desenho de implantação permitir.
Montar um arquivo separado não cria automaticamente uma foto coerente num instante de uma origem que está mudando. Se tabelas relacionadas da origem podem mudar durante a extração, defina o isolamento ou a estratégia de foto da origem de que a aplicação precisa antes de publicar o resultado.
Não suponha que trocar o nome de um arquivo muda automaticamente as conexões abertas da aplicação. Coordene essa transição com a aplicação. Não distribua um banco que está sendo gravado copiando só o arquivo principal; o WAL pode conter mudanças confirmadas que ainda não passaram pelo checkpoint. Use um backup que entende SQLite ou um procedimento controlado de publicação com o banco fechado. Documentação do WAL do SQLite
Neste passo a passo, o dbSlice roda como aplicativo Windows. Se os consumidores rodam em outro lugar, defina como um artefato SQLite validado chega até eles. Um diagrama com muitos nós de ponta não estabelece descoberta, entrega ou agendamento automáticos para esses nós.
7. Atualidade e operação offline
Um catálogo local pode continuar legível quando a conexão central está indisponível. Isso não torna todas as funções de negócio disponíveis offline. Autenticação, pagamentos, autorização ou outra API ainda podem exigir conexão. Falhas do disco local e da aplicação também continuam possíveis.
Defina o comportamento de forma explícita:
- Registre a hora da última atualização publicada com sucesso e a versão do conjunto de dados.
- Defina uma idade máxima aceitável para o modelo local.
- Decida quais funções podem continuar usando uma versão mais antiga.
- Mostre na aplicação um estado claro quando o limite de atualidade for ultrapassado.
- Tente de novo ou rode de novo as atualizações que falharam conforme a política operacional, preservando a última versão utilizável.
Numa foto agendada, a idade normal dos dados depende do intervalo entre as execuções, do tempo de extração e de gravação, da validação e da implantação. As falhas aumentam essa idade. Se o requisito é consistência imediata, uma cópia local periódica, sozinha, não basta.
Gravações offline exigem um desenho separado para fila, eliminação de duplicados, tratamento de conflitos e conciliação com o sistema oficial. A atualização de catálogo num só sentido deste artigo não implementa esse caminho de volta.
8. Mascaramento e tratamento de dados
A cópia seletiva pode reduzir a quantidade de dados distribuída a um destino. O mascaramento configurado pode transformar ainda os valores antes da gravação. Use esses recursos conforme o propósito dos dados: um ambiente de teste pode precisar de exemplos anonimizados, enquanto um catálogo operacional precisa preservar os valores necessários para o comportamento correto.
Revise as colunas escolhidas, as regras de transformação, as chaves e as chaves estrangeiras antes de mover conjuntos sensíveis. Confira os valores reais do destino depois da execução. Mascarar um subconjunto de colunas não demonstra que todas as informações identificadoras foram removidas.
A sincronia de banco para banco pode evitar um arquivo intermediário exportado à mão, mas o destino continua guardando os dados. Os logs dos bancos de origem e de destino, os backups, o armazenamento do sistema operacional e as exportações explícitas têm as suas próprias regras de retenção. Uma cópia SQLite na ponta é ela mesma um arquivo que precisa de controles de acesso e de gestão do ciclo de vida adequados.
Trate o mascaramento como um controle técnico dentro do processo de tratamento de dados da organização. Esta arquitetura não faz uma afirmação genérica de conformidade regulatória.
9. Valide a atualização
Confira mais do que o término bem-sucedido do processo. No exemplo dos serviços da categoria 1, compare a contagem filtrada da origem com a fatia no destino, inspecione as chaves estrangeiras e compare os valores das colunas pretendidas.
Origem SQL Server:
SELECT COUNT_BIG(*) AS service_count
FROM dbo.service
WHERE category_id = 1;
Destino SQLite:
PRAGMA foreign_keys = ON;

SELECT COUNT(*) AS service_count
FROM service
WHERE category_id = 1;

SELECT COUNT(*) AS orphan_services
FROM service AS s
LEFT JOIN category AS c ON c.id = s.category_id
WHERE c.id IS NULL;

PRAGMA foreign_key_check;
PRAGMA integrity_check;
Para a semente sintética sem mudanças, a fatia da categoria 1 na origem tem 2.042 linhas de serviço, derivadas da distribuição de categorias do gerador. Consulte a origem de novo se o conjunto de dados mudou. As verificações de chave estrangeira não devem encontrar violações, e a verificação de integridade deve devolver ok.
A configuração PRAGMA foreign_keys vale para a própria conexão; rodá-la num cliente de validação não configura a conexão de outro processo. Configure a verificação de forma adequada também para o gravador.
Contagens, sozinhas, não estabelecem igualdade. Use o fluxo de comparação do dbSlice para inspecionar diferenças de chave e de coluna, e revise as linhas que só existem no destino conforme a política de exclusão escolhida. Guarde a configuração do job, os logs e a versão do conjunto publicado como evidência operacional.
10. Meça o desempenho e o impacto no negócio
Meça o desempenho das consultas locais separado do desempenho da atualização. Uma transferência rápida para o PostgreSQL não estabelece a latência de uma consulta SQLite numa aplicação, e tirar uma ida e volta pela rede não garante um tempo de resposta específico.
| Pergunta | Medida |
|---|---|
| As consultas dos usuários ficaram mais rápidas? | Distribuições de latência de ponta a ponta, inclusive p50 e p95, antes e depois |
| O banco central está trabalhando menos? | Taxa de consultas, tempo de CPU, leituras e atividade de conexões, incluindo o custo das atualizações |
| A cópia local está atual o suficiente? | Idade da última versão publicada e violações do limite de atualidade |
| A aplicação tolera uma queda? | Funções testadas, dependências indisponíveis e comportamento de recuperação |
| O desenho escala na operação? | Duração das atualizações, número de destinos, falhas de implantação e esforço de suporte |
A redução de leituras é uma conta da carga
Seja B o número de requisições de leitura centrais na linha de base, L as requisições atendidas localmente no lugar delas e S as requisições adicionais de atualização no mesmo período. Um modelo simples por número de requisições é:
Remaining central read requests = B - L + S
Request reduction (%) = 100 × (L - S) / B
Isso não calcula diretamente a economia de CPU: cada consulta pode ter um custo muito diferente. Meça o recurso que você quer reduzir. O banco central continua fazendo as leituras de atualização, as transações e as consultas que continuam centralizadas.
Trate os números de custo como premissas de cenário
A ilustração de visão geral fornecida propõe um cenário de 50 nós com R$ 462.000 de economia anual e retorno em menos de quatro meses. Nenhum modelo de custo de apoio nem linha de base medida acompanha esses números; então eles não são resultados validados de clientes.
Numa conta explicitamente hipotética, R$ 462.000 divididos por 12 dão R$ 38.500 por mês. Um retorno simples em menos de quatro meses exigiria um investimento inicial abaixo de R$ 154.000 se R$ 38.500 já fossem o benefício mensal líquido e os benefícios começassem na hora. Custos recorrentes extras, tempo de implementação e benefícios atrasados mudariam essa conta.
Monte a estimativa a partir de mudanças documentadas no gasto com infraestrutura, no esforço de operação e no custo da implantação escolhida. Inclua licenças, implementação, gestão da ponta, monitoramento e o custo das atualizações. Mantenha as estimativas separadas das economias medidas.
Afirmações como uma redução fixa de 80% na carga, leituras abaixo de um milissegundo, escalabilidade ilimitada ou 100% de disponibilidade da aplicação não devem ser apresentadas como resultados universais desta arquitetura. Publique as medições com a carga, o hardware, as versões dos bancos e as condições de teste que as produziram.
11. Outros usos do mesmo fluxo
| Caso de uso | Como o fluxo se aplica |
|---|---|
| Migração entre bancos diferentes | Escolher os dados, mapear colunas compatíveis, transferir e conferir o destino |
| Tabelas preparadas para relatórios | Usar uma consulta de origem e um modelo de destino desenhado para o relatório |
| Atualização de ambiente de teste | Copiar um subconjunto pertinente, com regras de mascaramento revisadas onde forem exigidas |
| Entrega de conjunto de dados a terceiros | Exportar uma seleção combinada de dados no formato suportado pelo destinatário |
| Correção direcionada | Identificar as linhas que faltam ou que divergem e corrigir os registros pretendidos |
| Atualização agendada de catálogo | Repetir um job salvo e acompanhar a atualidade, as falhas e a validação |
Uma integração por API ou uma implantação com vários nós pode exigir uma camada adicional de entrega. Mantenha essa responsabilidade explícita, em vez de sugerir que todo protocolo de destino vem embutido num job de transferência de banco.
12. Uma implantação limitada
Comece com um catálogo, uma aplicação e um destino SQLite. Defina o requisito de atualidade e registre a carga atual antes de mudar o caminho de leitura da aplicação.
Preencha as dependências, valide a fatia e teste as consultas da aplicação contra a versão local. Provoque uma atualização interrompida e uma queda de rede. Confirme quais funções continuam utilizáveis e como a aplicação volta a um conjunto atualizado.
Expanda só depois que a equipe souber responder três perguntas práticas: qual versão dos dados está em uso, qual a idade dela e o que acontece se a próxima atualização falhar. Isso transforma as leituras locais num modelo de operação que a equipe consegue sustentar, e não só em mais uma cópia de banco.
Referências e arquivos que acompanham o guia
- Visão geral do produto dbSlice
- SQLite: usos adequados
- SQLite: write-ahead logging
- Job da tabela de tipos
- Job da tabela de categorias
- Job da fatia de serviços
Este artigo desenvolve a arquitetura e os casos de uso da apresentação dbSlice Technical Overview fornecida. O formato dos jobs de exemplo foi conferido com a implementação local do dbSlice. A topologia de ponta é um desenho de implantação proposto; nenhum novo benchmark de desempenho na ponta nem implantação em frota foi feito para este artigo.