
Num sistema que separa comandos de consultas, uma operação bem-sucedida é só o começo. Um comando foi aceito, um evento foi publicado, um projetor rodou, e o lado de leitura agora deveria mostrar o resultado. Se ele mostra mesmo é uma questão de dados, e costuma ser respondida à mão, com duas consultas e uma planilha.
O dbSlice pode tornar essa conferência repetível. Ele compara duas tabelas pela chave e, se você quiser, pelos valores das colunas escolhidas. Ele informa o que falta em cada lado e quais linhas diferem, e salva as chaves para a investigação continuar. Ele trabalha com os dados como estão no momento da leitura: a sua equipe decide o que comparar, qual janela usar e o que conta como correto.
Este guia segue a aba Synchronize do dbSlice 2.3, onde ficam os botões Record Diff e Compare, a aba Data view e a aba Replicator, que copia várias tabelas numa execução. Ele explica como aplicá-las a um banco de gravação e a um banco de leitura, como ler o resultado e onde a conferência termina. A disponibilidade pode variar conforme a licença.
1. As perguntas depois de uma operação bem-sucedida
"O comando devolveu sucesso" não diz que o modelo de leitura está certo. Estas são as perguntas que ficam.
| Pergunta | O que a comparação mostra |
|---|---|
| Os IDs esperados chegaram? | As chaves presentes nos dois lados são contadas como correspondentes. |
| Há registros faltando? | As chaves que existem num lado e não no outro são listadas como Missing in destination ou Missing in source. |
| Os valores dos campos escolhidos batem com o mapeamento pretendido? | Com Also compare column values, as linhas que têm a mesma chave mas diferem num valor são listadas em Rows with different values, coluna a coluna. |
| Uma diferença é atraso da projeção, uma transformação intencional ou um defeito? | A ferramenta mostra a diferença. Decidir o que ela significa é uma etapa de revisão, descrita na seção 8. |
2. Onde o dbSlice entra
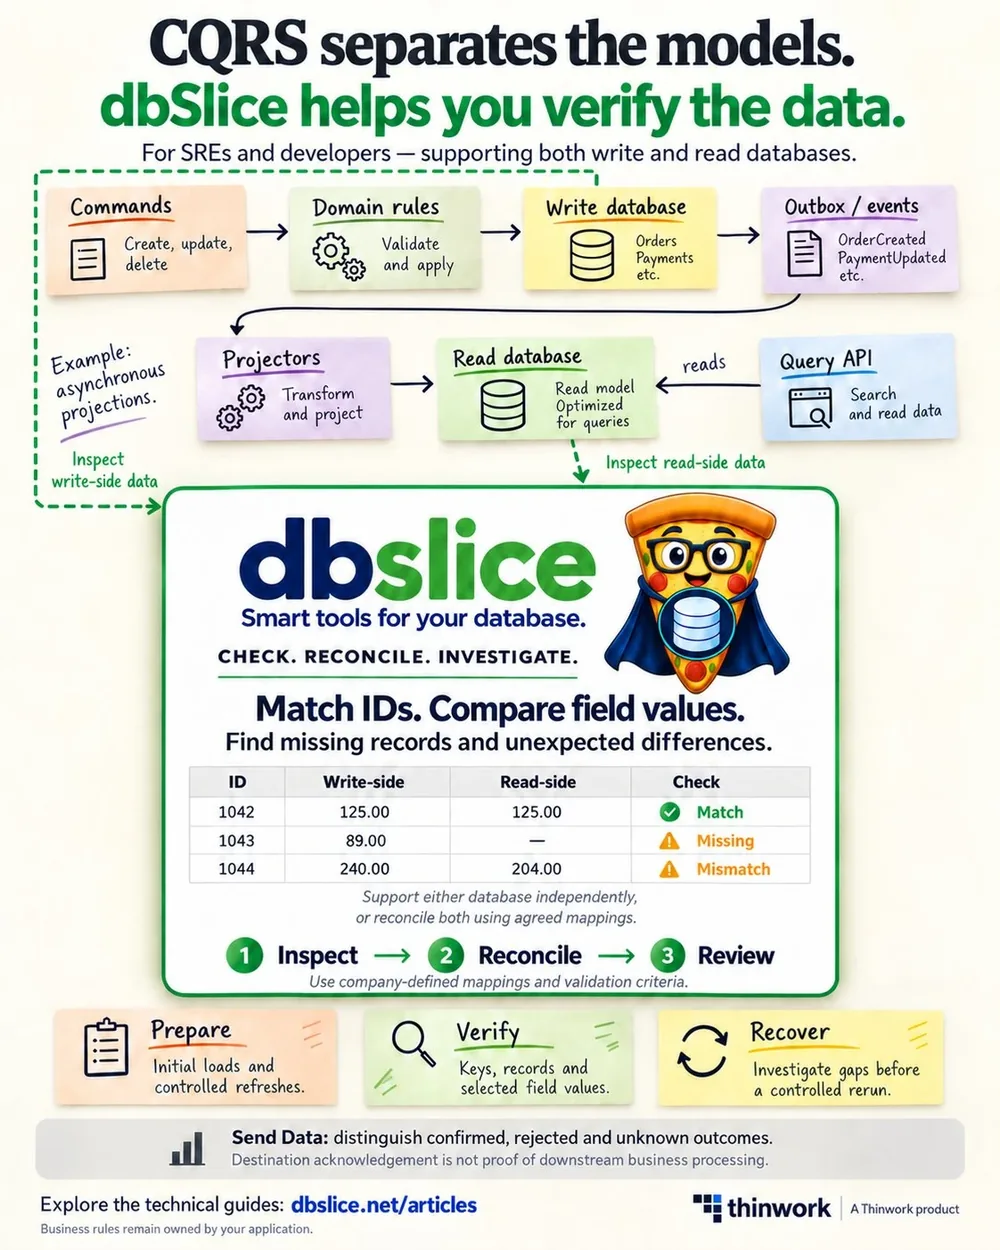
O dbSlice não faz parte do caminho dos comandos nem do caminho da projeção. Ele fica ao lado e lê. Pode ser apontado para o banco de gravação, para o banco de leitura ou para os dois.
| Uso | O que você faz |
|---|---|
| Apoiar um banco sozinho | Inspecionar o banco de gravação ou o de leitura de forma independente: navegar pelas linhas no Data view, exportar um conjunto escolhido ou gerar uma lista de chaves. |
| Conciliar os dois | Apontar o Source para um banco e o Target para o outro, e deixar o dbSlice casar as chaves e comparar as colunas escolhidas. |
| Preparar e recuperar | Apoiar cargas iniciais e atualizações controladas de um banco de leitura, e investigar as lacunas encontradas antes de rodar de novo com controle. |
3. Defina o escopo primeiro
Uma comparação só tem o sentido da pergunta por trás dela. Antes de abrir a aba, combine quatro coisas com a equipe dona da aplicação.
- O par de tabelas. Uma execução compara uma tabela ou consulta do lado da origem com uma tabela do lado do destino. Um modelo de leitura montado a partir de várias tabelas precisa de uma consulta comparável, tratada na seção 9.
- A chave. A comparação precisa de uma coluna-chave única em cada lado. Os dois lados podem dar nomes diferentes a ela; a chave do destino é escolhida à parte.
- As colunas que importam. Decida quais campos precisam bater e quais devem diferir porque a projeção os transforma. O mapeamento de colunas permite comparar só as colunas mapeadas.
- A janela. Gravações e projeções não acontecem no mesmo instante. Escolha um período em que o lado de leitura já deveria ter alcançado o de gravação, e compare as linhas desse período. A seção 9 explica como limitar as linhas lidas.
O escopo, os dados de referência e os critérios de validação são da sua equipe. O dbSlice os aplica de forma consistente; ele não os deduz.
4. Inspecione um lado sozinho
Nem toda pergunta precisa de dois bancos. Se há suspeita de que um registro está errado no lado de gravação ou no de leitura, olhe esse lado primeiro.
A aba Data view é uma grade só de leitura da origem, com paginação para a frente e para trás e um contador de linhas. Você pode copiar as linhas escolhidas, exportar a página visível para CSV e abrir um registro campo a campo. Ela não altera dados.
Para levar uma seleção a outro lugar, a aba Export tem duas saídas feitas para isso: SQL — key IN (…) e CSV — key list. Elas gravam as chaves das linhas que você escolheu, para colar numa consulta ou entregar a outra equipe.
5. Concilie o lado de gravação e o de leitura
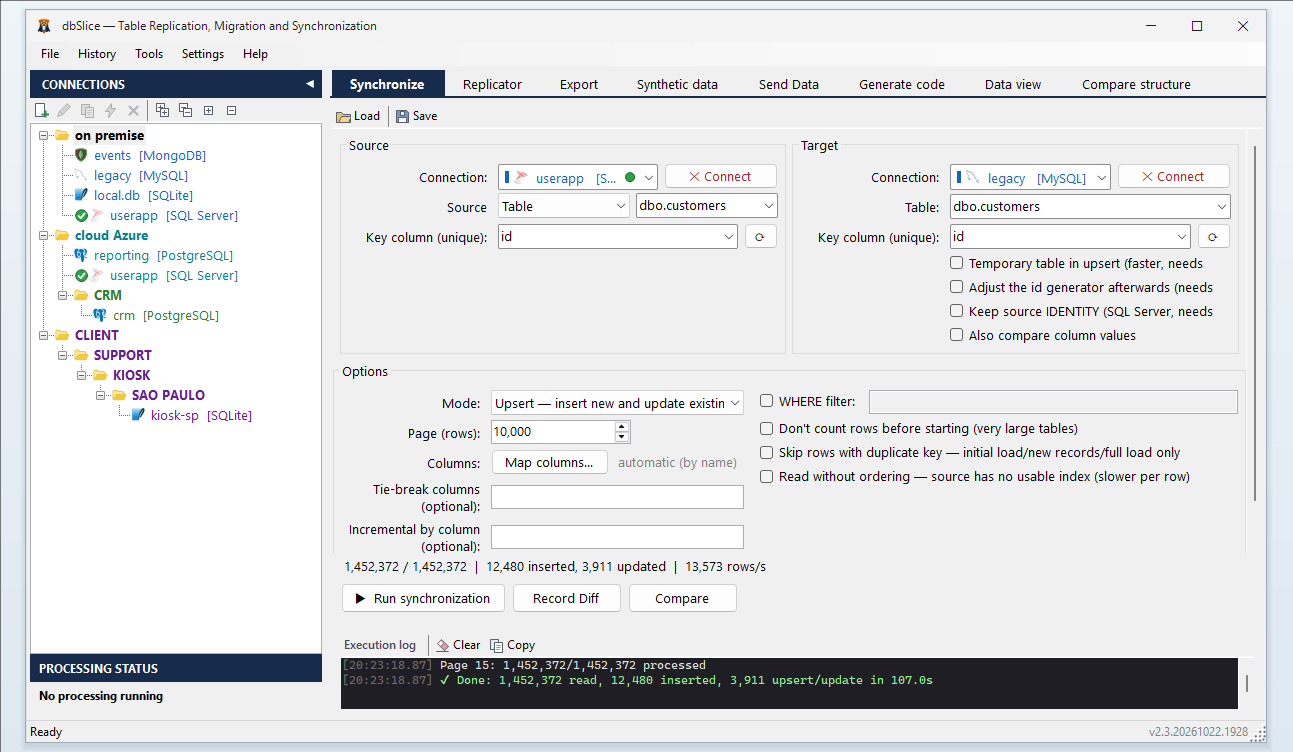
A conciliação roda pela aba Synchronize. Os mesmos campos que configuram uma cópia configuram a comparação, e a comparação em si só lê.
| Controle | Para que serve na conciliação |
|---|---|
| Source: conexão, tipo de origem, objeto, coluna-chave | Um lado da comparação. O tipo de origem pode ser uma tabela, uma view ou um SELECT. A coluna-chave precisa ser única. |
| Target: conexão, tabela, coluna-chave | O outro lado. A coluna-chave dele pode ter outro nome. |
| Map columns... | Quais colunas da origem correspondem a quais colunas do destino. Automático pelo nome, a menos que você as mapeie. |
| WHERE filter | Restringe as linhas lidas da origem. Não é aplicado ao destino, como explicado na seção 9. |
| Also compare column values | Acrescenta uma comparação de valores das colunas mapeadas, além da comparação de chaves. |
| Record Diff | Conferência só de chaves, só leitura. |
| Compare | Conciliação, só leitura. Com Also compare column values, também informa os valores que diferem. |
| Log de execução | Contagens, as primeiras chaves que diferem e o resultado da execução. |
Nem o Record Diff nem o Compare gravam em nenhum dos dois bancos. O Run synchronization é o botão que grava, e ele não é necessário para conciliar.
Qual banco é a origem e qual é o destino é escolha sua. Os rótulos no log seguem essa escolha: uma chave encontrada só na origem é informada como faltando no destino, e uma chave encontrada só no destino é informada como faltando na origem. Escolha o sentido que combina com a pergunta, por exemplo "lado de gravação como origem" para perguntar o que ainda não chegou ao lado de leitura.
6. Record Diff: a conferência rápida de chaves
O Record Diff lê só a coluna-chave dos dois lados. É a conferência rápida para rodar primeiro, porque precisa de poucos dados de cada banco.
O log informa o número de linhas em cada lado, as chaves que existem só na origem, as que existem só no destino e o total de registros que diferem. Quando a origem é uma tabela ou view, o log também mostra um SELECT … WHERE key IN (…) pronto, com as primeiras chaves que faltam, para as linhas poderem ser inspecionadas na origem na hora.
O Record Diff não diz nada sobre valores. Duas linhas com a mesma chave e conteúdo diferente são, para o Record Diff, iguais.
7. Compare: chaves e valores dos campos
O Compare roda a mesma conciliação de chaves. Com Also compare column values marcado, ele também confere as colunas mapeadas.
Para isso, o dbSlice lê o destino uma vez e guarda, para cada chave, uma impressão digital compacta dos valores das colunas comparadas. Depois lê a origem e compara a impressão digital de cada linha com a guardada para a mesma chave. Para uma amostra das linhas que diferem, ele lê de novo os valores reais e os lista coluna a coluna no log, no formato key: column [source value ≠ target value].
Como os valores são comparados
Os dois bancos podem guardar o mesmo valor em tipos diferentes. Para não acusar diferenças que são só de representação, os valores são normalizados antes da comparação.
| Tipo de valor | Como é comparado |
|---|---|
| Texto | Os espaços no começo e no fim são ignorados. Fora isso, a comparação é exata; então a e A são diferentes. |
| Números | Convertidos para a mesma forma decimal, qualquer que seja o tipo; então 10 e 10.00 são iguais. |
| Booleanos | Comparados como 1 e 0. |
| Datas e horas | Comparadas num formato completo de ida e volta. Um valor guardado com menos precisão num dos lados pode aparecer como diferença. |
| NULL | NULL é igual a NULL. NULL e string vazia são valores diferentes. |
Para uma coluna que o modelo de leitura transforma de propósito, compare com o valor esperado depois da transformação, e não com o original. Uma comparação dos valores brutos vai acusar diferença ali, e isso está correto: é a transformação. Separe as diferenças intencionais dos registros que faltam e das mudanças inesperadas de mapeamento.
8. Leia o resultado
O resultado tem três categorias. O que cada uma sugere depende do sistema; então trate a coluna da direita como uma lista de lugares para olhar, e não como um diagnóstico.
| Categoria | Significado | Onde olhar |
|---|---|---|
| Igual | A chave existe nos dois lados e, se os valores foram comparados, os valores escolhidos são iguais. | Nada a fazer nas colunas comparadas. As colunas que não foram comparadas não estão cobertas. |
| Faltando | A chave existe só num lado. | Atraso da projeção; um evento que não foi publicado ou não foi consumido; uma falha do projetor; uma exclusão que não se propagou; um filtro que exclui a linha num dos lados. |
| Diferente | A chave existe nos dois lados, e um valor escolhido difere. | Uma transformação intencional; um mapeamento que mudou; um projetor que aplicou um evento mais antigo; uma coluna preenchida a partir de outra origem. |
O atraso é o motivo mais comum de uma lacuna e o mais fácil de descartar: rode a comparação de novo mais tarde. Uma chave que faltava e chegou era atraso. Uma chave que continua faltando precisa de investigação. Rodar duas vezes e comparar os dois resultados é um jeito simples de separar as diferenças que se mexem das estáveis.
9. Projeções que transformam ou agregam
Um modelo de leitura nem sempre é a cópia de uma tabela. Ele pode juntar, achatar ou totalizar dados de várias tabelas. Uma comparação direta de tabela com tabela não serve aí, e a comparação precisa ser definida.
- Use uma consulta do lado da origem. Ponha o tipo de origem em SELECT e escreva uma consulta que devolva a mesma granularidade da tabela de leitura: uma linha por chave, com as colunas que você quer comparar. A coluna-chave precisa estar no resultado da consulta.
- Informe a tabela de destino. Quando a origem é um SELECT, a tabela de destino é obrigatória. O mapeamento de colunas à mão não está disponível para um SELECT; as colunas são casadas pelo nome; então dê às colunas da consulta os nomes usados pelo destino.
- Compare igual com igual. Se o lado de leitura guarda um total, calcule o mesmo total na consulta, com a mesma regra de arredondamento, status e período.
- Fixe a janela de conferência. O filtro WHERE, ou uma condição dentro da consulta, limita as linhas lidas da origem. A tabela de destino inteira é lida. As linhas do destino que ficam fora da janela vão aparecer, então, como faltando na origem. Use uma tabela ou view de destino que guarde só a mesma janela quando precisar de um resultado estrito, ou ignore essa categoria de propósito.
A sua aplicação continua dona das regras de negócio. O dbSlice compara os dois conjuntos de resultados; ele não sabe por que um total deveria ser o que é.
10. Guarde a lista de chaves que diferem
No fim de um Record Diff ou de um Compare que encontrou diferenças, o dbSlice oferece salvar as chaves. O arquivo é um texto com uma seção por categoria: faltando no destino, faltando na origem e linhas com valores diferentes. Em cada seção, os IDs são separados por vírgula e espaço, prontos para colar num WHERE key IN (…).
O log e o arquivo guardam uma amostra, não uma lista ilimitada: até 1.000 chaves por categoria. Quando uma categoria tem mais, o arquivo informa o total real ao lado do número de chaves listadas. As contagens no log são sempre completas.
Use a lista para olhar as mesmas linhas nos dois bancos, para entregar um conjunto preciso à equipe dona do projetor, ou para rodar uma correção controlada exatamente dessas chaves, como descrito na seção 11.
11. Replique: monte ou atualize um banco de leitura
A aba Replicator tem o seu próprio guia: Replique várias tabelas numa execução.
Comparar é metade do trabalho. Quando a comparação mostra que um banco de leitura está vazio, desatualizado ou sem um conjunto de chaves, o dbSlice também pode gravar. A aba Replicator, ao lado da Synchronize, copia uma lista de tabelas de uma conexão para outra numa só execução. Enquanto a Synchronize trabalha com uma tabela por vez, o Replicator leva as tabelas que você marcar.
A aba Replicator
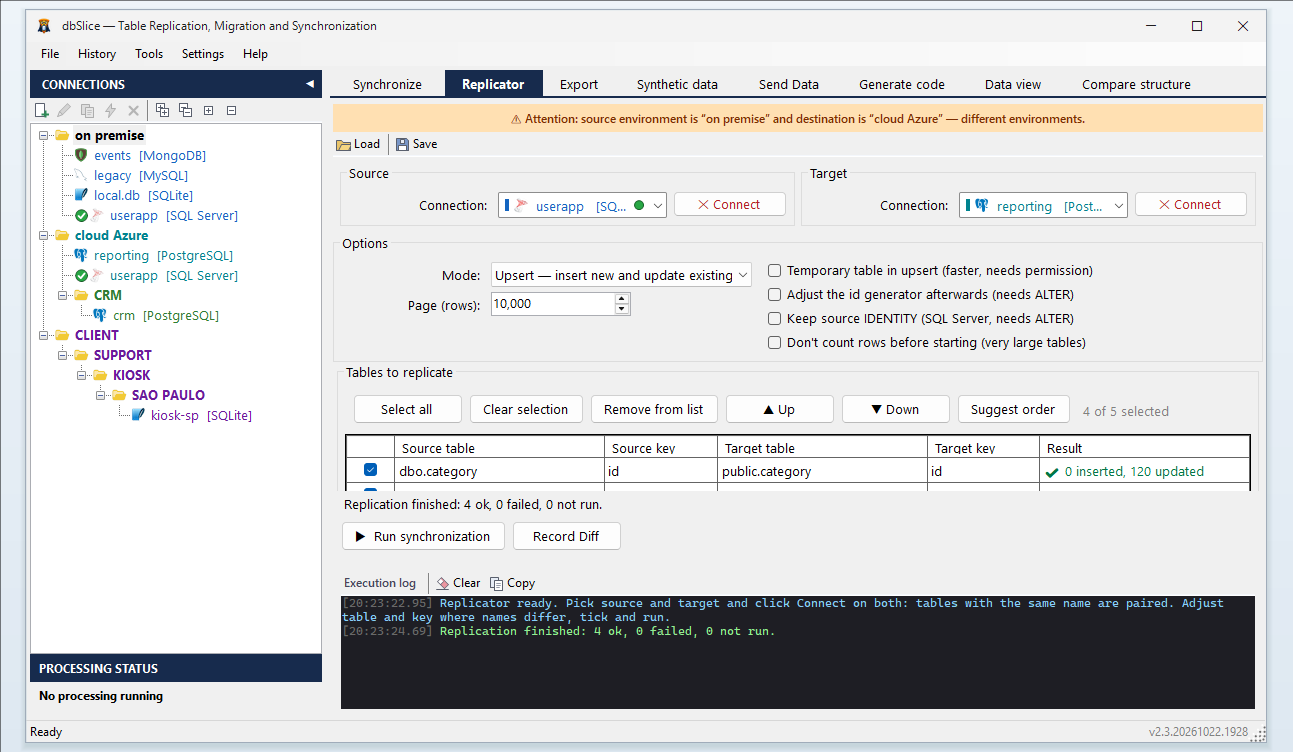
| Controle | Para que serve |
|---|---|
| Conexões Source e Target | O banco de onde ler e o banco onde gravar. Clique em Connect nos dois; as tabelas de cada um são carregadas. |
| Mode | O que uma execução pode fazer em cada tabela de destino. É escolhido uma vez para todas as tabelas da execução. |
| Page (rows) | Quantas linhas são lidas e gravadas por vez. |
| Create table on target if missing (migration) | Cria uma tabela de destino que ainda não existe, traduzindo os tipos das colunas entre os dois bancos. |
| Keep source IDENTITY (SQL Server) | Mantém os valores de identity de uma origem SQL Server, em vez de deixar o destino gerar valores novos. No SQL Server, quando o destino tem uma coluna IDENTITY, o Upsert e o New rows only param antes de gravar qualquer coisa e explicam o que o seu DBA precisa fazer: o SQL Server só aceita a chave da origem com o identity desligado, e o dbSlice não muda as configurações do seu banco. O Keep source IDENTITY (Initial load e Full load) exige permissão de ALTER na tabela de destino; sem ela, o dbSlice avisa, em vez da mensagem enganosa do SQL Server de 'objeto não encontrado'. |
| Don't count rows before starting (very large tables) | Pula a contagem inicial, o que poupa tempo em tabelas muito grandes. |
| Tables to replicate | Uma linha por tabela: tabela de origem, chave de origem, tabela de destino, chave de destino e o resultado da última execução. Uma caixa de seleção escolhe a linha; Select all, Clear selection e Remove from list cuidam da lista, e um contador mostra quantas estão marcadas. |
| Run synchronization, Record Diff | Rodam a replicação das tabelas marcadas, ou a conferência de chaves. |
| Cancel (painel Processing status) | Para uma execução em andamento. |
| Load e Save | Guardam uma configuração e a reabrem depois. |
| Log de execução | As tabelas carregadas e, para cada tabela, as linhas lidas, inseridas e atualizadas, com o tempo dividido em leitura, transformação e gravação, e uma contagem final das tabelas concluídas. |
As tabelas com o mesmo nome nos dois lados são pareadas automaticamente. Onde os nomes diferem, ajuste a tabela de destino e a chave na linha, marque e rode. Depois de uma execução, a coluna Result mostra o resultado de cada tabela, por exemplo 0 inserted, 120 updated, e o log termina com um resumo como Replication finished: 2 ok, 0 failed, 0 not run.
Como uma execução se comporta
- Ordem. As tabelas marcadas rodam uma por vez, na ordem da lista. As setas sobem ou descem uma tabela, e o Suggest order propõe as pais antes das filhas, usando as chaves estrangeiras do destino, e as menores primeiro entre as que podem ir.
- Uma tabela que falha. Não para as outras. A execução continua, e a falha aparece na coluna Result e no log.
- Cancel. Para a execução no ponto em que está. As tabelas que não tinham começado aparecem como não rodadas.
- Confirmações. O Full load lista até dez tabelas que serão esvaziadas. Gravar num perfil somente leitura, ou entre ambientes diferentes, também pergunta antes.
- O Full load esvazia primeiro todas as tabelas marcadas. Faz isso das filhas para as pais, sem CASCADE, e se recusa antes de excluir quando uma tabela fora da lista se refere à lista, uma filha vem antes da pai, uma tabela de destino não existe ou as chaves estrangeiras não podem ser lidas. As tabelas ficam vazias até a carga terminar; então use uma janela de manutenção. O guia do Replicator tem os detalhes.
- Identificadores. Depois de gravar linhas com os ids da origem, o dbSlice avança o gerador de ids da tabela até o maior id gravado — sequences do PostgreSQL, colunas identity do Firebird 3+ e do Oracle 12c+ —, só para a frente, para a próxima inclusão no seu sistema não repetir um id. Se não conseguir (por exemplo, por falta de permissão), as linhas continuam gravadas e o log avisa que o seu DBA precisa avançar o gerador. Um gerador movido por trigger (no estilo do Firebird 2.5) não é ajustado.
- O que não é por tabela. Não há filtro WHERE, mapeamento de colunas nem mascaramento nesta aba, e a origem é uma tabela, não uma consulta. Use a aba Synchronize quando uma tabela precisar disso.
- Sem retomada por tabela. Uma tabela grande que foi interrompida é retomada na aba Synchronize.
- Record Diff. A mesma conferência só de chaves da Synchronize, para cada tabela marcada. Não compara valores.
- Configuração salva e linha de comando. O Save grava um arquivo
*_replicator.json, e um job do tiporeplicateo roda sem a tela.
Quando usar
- A primeira carga. O banco de leitura é novo, ou novas tabelas de leitura foram acrescentadas, e elas precisam do histórico existente.
- Uma atualização controlada. Uma projeção mudou e várias tabelas precisam ser reconstruídas a partir do lado de gravação.
- Um banco de leitura em outro banco. O lado de gravação roda num banco e o de leitura em outro, por exemplo o SQL Server gravando e o PostgreSQL lendo. O dbSlice traduz os tipos entre os dois.
- Um modelo de leitura num sistema NoSQL. MongoDB, Cassandra, Elasticsearch, Couchbase e Redis podem ser o destino, como descrito no guia do Replicator. O Record Diff e o Compare ainda não funcionam com destino NoSQL.
- Uma correção direcionada. Para um conjunto de chaves encontrado pelo Compare, use a aba Synchronize: o filtro WHERE dela limita a execução a essas chaves.
Escolha o modo
O modo decide o que uma execução pode fazer no destino. A aba Synchronize lista esses modos e informa o impacto do escolhido antes da execução. A aba Replicator da figura usa Upsert.
| Modo | O que faz no destino | Use para |
|---|---|---|
| Upsert — insert new and update existing | Insere as chaves que faltam e atualiza as linhas que mudaram. Não exclui. | Atualização e correções direcionadas. |
| New rows only (skip existing keys) | Insere só as chaves que não estão no destino. As linhas existentes não são tocadas. | Preencher lacunas sem mudar o que já está lá. |
| Update existing only (UPDATE) | Atualiza as linhas cuja chave existe. Sem inclusões, sem exclusões. | Corrigir valores em linhas que já chegaram. |
| Initial load (INSERT into empty table) | Insere todas as linhas e falha se uma chave já existe. | A primeira carga de uma tabela de leitura vazia. |
| Full load (TRUNCATE + INSERT) | Exclui todas as linhas do destino e recarrega a partir da origem. | Reconstruir uma tabela de leitura do zero. Use com cuidado. |
Só o último modo remove linhas. Nos outros, uma linha que existe só no destino continua lá, e um Compare posterior ainda a informa como faltando na origem. As exclusões que aconteceram no lado de gravação não são levadas por esses modos; então pedem uma decisão própria.
Torne a nova execução controlada
- Marque só as tabelas de que precisa. O contador mostra quantas estão marcadas antes da execução.
- Escolha o modo mais estreito. New rows only para uma lacuna, update existing only para um valor.
- Confirme o destino. Confira que a conexão Target é o banco de leitura e não o de gravação. Uma nova execução grava nele.
- Confira depois. Rode de novo o Record Diff ou o Compare no mesmo escopo e confirme que as diferenças sumiram.
Uma execução começa quando você a inicia. O dbSlice não é um serviço de replicação contínua e não acompanha o log do banco de gravação. Manter um lado de leitura em dia entre as execuções continua sendo trabalho das projeções da aplicação.
12. Preparar, conferir, recuperar
| Etapa | Como o dbSlice apoia |
|---|---|
| Preparar | Cargas iniciais e atualizações controladas de um banco de leitura, como descrito na seção 11, com uma configuração salva na aba Replicator. Veja também o guia de movimentação controlada de dados. |
| Conferir | Chaves, registros e valores de campos escolhidos, com o Record Diff e o Compare, como descrito acima. |
| Recuperar | Investigue as lacunas primeiro. Quando uma nova execução controlada for a resposta certa, restrinja-a às chaves da lista salva e revise o resultado com o Compare de novo. |
Uma nova execução grava no destino. Se o destino é um modelo de leitura alimentado por projetores, copiar linhas para ele contorna a projeção e pode esconder o motivo de a lacuna ter aparecido. Decida com a equipe se a recuperação certa é reprocessar o caminho dos eventos na aplicação ou atualizar as linhas diretamente.
13. Rode pela linha de comando
A mesma conferência só de leitura pode rodar sem a tela. Um job salvo do tipo Status compara a origem e o destino, inclusive os valores das colunas, e informa no resultado as contagens de linhas iguais, faltando e diferentes. É a forma de usar quando a conferência se repete, por exemplo depois de cada atualização da projeção, e o resultado precisa ficar guardado junto com os outros relatórios de jobs.
14. Send Data: confirmado, rejeitado e desconhecido
Alguns fluxos do lado de gravação entregam dados a outro sistema, e não a um banco. Nesses, a aba Send Data mantém três resultados separados: confirmado, rejeitado e desconhecido. Veja o guia do Send Data.
Uma confirmação do destino significa que o destino respondeu. Não estabelece que todas as operações de negócio posteriores foram concluídas. Uma conciliação dos dados do próprio destino continua sendo a conferência para isso.
15. O que esta conferência não faz
- Lê um momento, não um fluxo. O resultado descreve os dados quando foram lidos. Linhas gravadas durante uma execução longa podem ser contadas só de um lado. Escolha uma janela calma ou um período estável, e repita a execução para confirmar.
- Não conhece o atraso da projeção. Uma diferença causada por atraso é informada como qualquer outra diferença.
- Não confere um modelo de leitura NoSQL. Os sistemas NoSQL são só destino, e o Record Diff e o Compare ainda não funcionam com eles.
- Compara um par de tabela ou consulta por execução. Um modelo de leitura inteiro precisa de várias execuções.
- O destino é lido por inteiro. O filtro WHERE vale para a origem. O conjunto de chaves, ou as impressões digitais das colunas comparadas, ficam na memória enquanto a execução dura; então destinos muito grandes precisam de uma máquina com memória suficiente.
- Precisa de uma chave única dos dois lados. Sem ela, as linhas não podem ser casadas.
- Impressões digitais iguais são tratadas como valores iguais. A comparação de valores foi feita para ser rápida em tabelas grandes; as diferenças listadas sempre mostram os valores reais.
- Não aplica as suas regras de negócio. Uma regra de que um pedido fechado precisa ter data de fechamento, ou de que um total é líquido de descontos, pertence à aplicação. Codifique-a na consulta que você compara.
- Não corrige. O Record Diff e o Compare só leem. Qualquer correção é uma execução à parte e deliberada, como descrito na seção 11.
Uma primeira conciliação com cuidado
- Escolha uma tabela e escreva a pergunta: quais chaves, quais colunas, qual período.
- Confirme que os dois lados têm uma chave única, e decida qual banco é a origem.
- Conecte nos dois bancos com contas que podem ler, não gravar.
- Ponha o filtro WHERE, ou o SELECT, na janela de conferência.
- Rode primeiro o Record Diff e leia as contagens.
- Mapeie as colunas e marque Also compare column values.
- Rode o Compare e leia a amostra de linhas que diferem.
- Salve a lista de chaves que diferem.
- Rode de novo depois de um intervalo curto e compare os dois resultados, para separar atraso de lacunas estáveis.
- Leve as diferenças estáveis aos donos do caminho de gravação e da projeção antes de decidir por uma nova execução.
Escopo deste guia
Os controles e as linhas de log descritos aqui foram tirados de uma captura da aba Synchronize do dbSlice 2.3 e da implementação do Record Diff, do Compare, da lista salva de chaves que diferem, dos modos de sincronia e do job do tipo Status no modo de linha de comando. O comportamento da aba Replicator, inclusive a ordem das tabelas, uma tabela que falha e uma execução cancelada, é descrito no guia próprio e foi confirmado com a implementação do aplicativo.
Nenhum sistema CQRS foi conciliado para escrever este artigo, e nenhum número de velocidade ou capacidade é afirmado. A tabela da figura é ilustrativa e a captura usa tabelas sintéticas de documentação. As causas listadas na seção 8 são lugares para olhar, não o diagnóstico de nenhum sistema específico.