
Migrar um banco normalmente significa migrar muitas tabelas. Montar um banco de relatórios, atualizar um modelo de leitura ou preencher um ambiente de teste significa repetir a mesma cópia para dezenas de tabelas: escolher a origem, escolher o destino, escolher a chave, rodar, ler o resultado e começar de novo.
A aba Replicator elimina essa repetição. Ela lê as tabelas de duas conexões, monta a lista a partir das tabelas do destino, pareia cada uma com a tabela de origem, pelo mesmo nome ou por uma regra de nomes, e roda as que você marcar, uma depois da outra, com o mesmo motor que a aba Synchronize usa para uma tabela.
Este guia segue a aba Replicator: os controles, como as tabelas são pareadas, os modos, a ordem de execução, o que acontece quando uma tabela falha ou a execução é cancelada, a conferência de chaves e como salvar o trabalho e rodar pela linha de comando. A disponibilidade pode variar conforme a licença.
1. Replicator ou Synchronize?
As duas abas copiam linhas de uma tabela de origem para uma tabela de destino. Elas diferem em quantas tabelas uma execução cobre e em quanto dá para ajustar em cada uma.
| Synchronize | Replicator | |
|---|---|---|
| Tabelas por execução | Uma. | Todas as que você marcar. |
| Origem | Uma tabela, uma view ou um SELECT. | Tabelas. |
| Filtro WHERE | Sim. | Não. |
| Mapeamento de colunas e mascaramento | Sim. | Não. As colunas são casadas pelo nome. |
| Modos | Cinco. | Os mesmos cinco, para a execução toda. |
| Retomada de uma tabela interrompida | Por ponto de controle. | Não. Retome no Synchronize. |
| Record Diff (conferência de chaves) | Uma tabela. | Cada tabela marcada. |
Use o Replicator para abrangência, quando as mesmas regras valem para muitas tabelas. Use o Synchronize para profundidade, quando uma tabela precisa de filtro, mapeamento ou máscara.
2. Leia a aba Replicator
A aba fica ao lado da Synchronize. Ela tem duas conexões no alto, um grupo de opções, a lista de tabelas e, abaixo, os botões de ação e o log de execução. A barra de progresso e o botão Cancel ficam no painel fixo Processing status, abaixo da árvore de conexões.
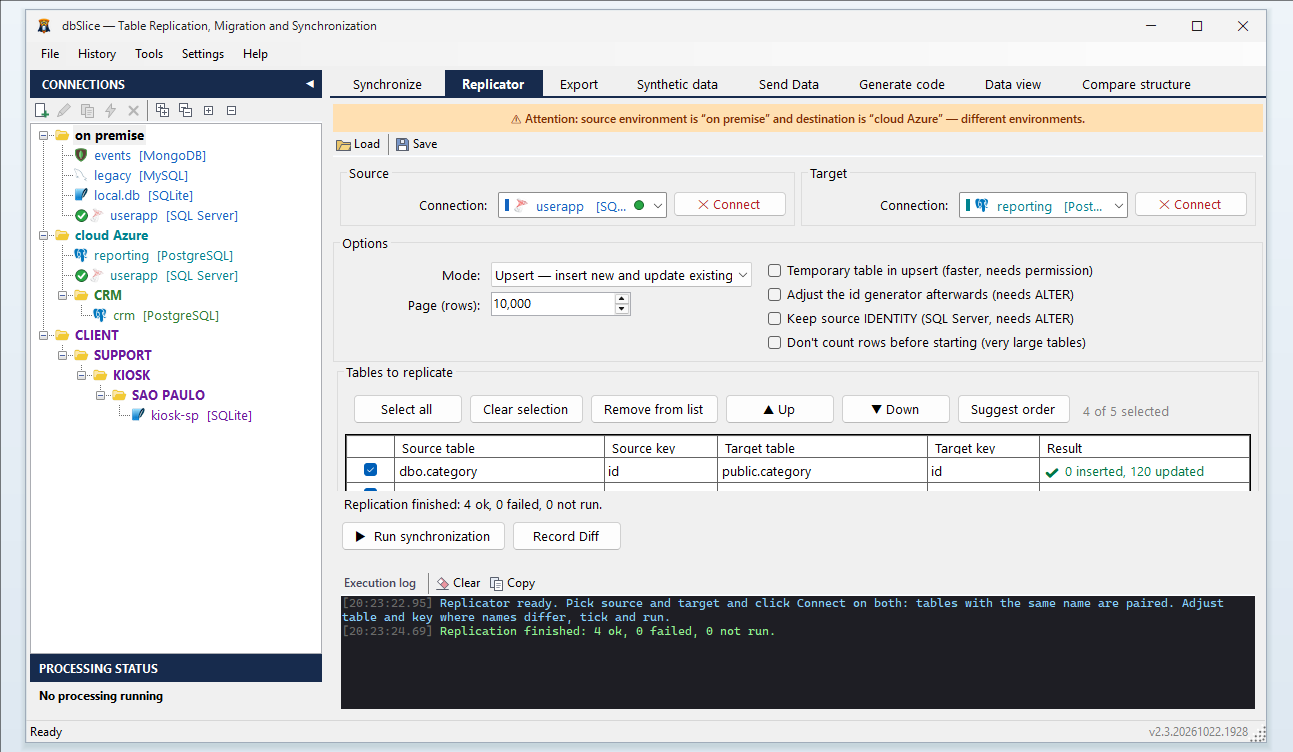
| Controle | Para que serve |
|---|---|
| Conexão Source e Target | O banco de onde ler e o banco onde gravar. Clique em Connect nos dois; as tabelas de cada um são carregadas. |
| Mode | O que uma execução pode fazer em cada tabela de destino. Uma escolha para a execução toda. |
| Page (rows) | Quantas linhas são lidas e gravadas por vez. |
| Create table on target if missing (migration) | Cria uma tabela de destino que não existe, traduzindo os tipos das colunas entre os dois bancos. |
| Keep source IDENTITY (SQL Server) | Mantém os valores de identity de uma origem SQL Server, em vez de deixar o destino gerar valores novos. No SQL Server, quando o destino tem uma coluna IDENTITY, o Upsert e o New rows only param antes de gravar qualquer coisa e explicam o que o seu DBA precisa fazer: o SQL Server só aceita a chave da origem com o identity desligado, e o dbSlice não muda as configurações do seu banco. O Keep source IDENTITY (Initial load e Full load) exige permissão de ALTER na tabela de destino; sem ela, o dbSlice avisa, em vez da mensagem enganosa do SQL Server de 'objeto não encontrado'. |
| Don't count rows before starting (very large tables) | Pula a contagem inicial, o que poupa tempo em tabelas muito grandes. |
| Tables to replicate | Uma linha por tabela de destino: tabela de destino, chave de destino, tabela de origem, chave de origem e resultado. Uma caixa de seleção escolhe a linha. |
| Select all, Clear selection, Remove from list | Cuidam das marcações e da lista. Um contador mostra quantas tabelas estão marcadas do total. |
| Up (▲), Down (▼) e Suggest order | Sobem ou descem a tabela escolhida na lista, ou deixam o dbSlice propor uma ordem. A ordem da lista é a ordem de execução. |
| Run synchronization, Record Diff | Replicam as tabelas marcadas, ou rodam a conferência de chaves nelas. |
| Cancel (painel Processing status) | Para a execução. |
| Load e Save | Guardam a configuração e a reabrem depois. |
| Log de execução | As tabelas carregadas, o resultado de cada tabela e um resumo da execução. O Open in window mostra o log numa janela maior, com Save (.txt ou .rtf), Print e PDF. |
3. Pareie as tabelas
O destino é a referência: o dbSlice lista as tabelas da conexão de destino e preenche a tabela de origem de cada uma, primeiro pela regra de nomes e depois pelo mesmo nome. Quando os nomes diferem por um prefixo, use a regra de nomes com *: origem T* e destino TR* pareiam T000001_USER com TR000001_USER (a parte casada pelo * é mantida). O Rebuild pairs lê os dois lados de novo e monta a lista do zero, mantendo as marcações e as chaves dos pares que não mudaram. O Find filtra a lista pelo nome. Se o destino ainda não tem tabelas, a lista vem da origem.
A comparação pelo mesmo nome ignora maiúsculas e o esquema; então dbo.Customer numa origem SQL Server pareia com public.customer num destino PostgreSQL.
As linhas sem tabela de origem são as que a regra não casou: escolha a origem na grade ou ajuste a regra de nomes e clique em Rebuild pairs.
- Nomes diferentes. Escolha a tabela de destino na linha.
- A chave. Cada linha tem uma chave de origem e uma chave de destino. Elas podem ter nomes diferentes. A chave precisa ser única, porque é ela que identifica uma linha em cada lado.
- Tabelas sem par. Tire-as da lista, ou deixe-as desmarcadas.
As tabelas são lidas da origem como tabelas. Não há consulta como origem nesta aba; uma tabela que precisa de filtro, join ou mapeamento vai para a aba Synchronize.
4. Escolha o modo
O modo é o mesmo para todas as tabelas da execução. É a mesma lista da aba Synchronize, com os mesmos textos.
| Modo | O que faz em cada tabela de destino | Use para |
|---|---|---|
| Upsert — insert new and update existing | Insere as chaves que faltam e atualiza as linhas que mudaram. Não exclui. | Atualizar uma cópia que já existe. |
| New rows only (skip existing keys) | Insere só as chaves que não estão no destino. As linhas existentes não são tocadas. | Preencher lacunas sem mudar o que já está lá. |
| Update existing only (UPDATE) | Atualiza as linhas cuja chave existe. Sem inclusões, sem exclusões. | Corrigir valores em linhas que já chegaram. |
| Initial load (INSERT into empty table) | Insere todas as linhas e falha se uma chave já existe. | A primeira carga de tabelas vazias. |
| Full load (TRUNCATE + INSERT) | Exclui todas as linhas de cada tabela de destino e recarrega a partir da origem. | Reconstruir as cópias do zero. Use com cuidado. |
Só o Full load remove linhas. Nos outros modos, uma linha que existe só no destino continua lá.
Confirmações antes de gravar
O dbSlice pede confirmação nos casos em que um erro sairia caro. São as mesmas confirmações da aba Synchronize.
- Full load. A confirmação lista as tabelas que serão esvaziadas, até dez delas. Como elas são esvaziadas está descrito na próxima subseção.
- Um perfil somente leitura como destino. Gravar numa conexão marcada como somente leitura pede confirmação.
- Ambientes diferentes. Quando a origem e o destino pertencem a ambientes diferentes, por exemplo produção e teste, a execução pergunta antes de gravar. Uma faixa laranja no alto da aba avisa disso assim que as duas conexões são escolhidas, como na figura.
Full load no Replicator
O Full load nesta aba não esvazia cada tabela logo antes de carregá-la. Primeiro ele lê as chaves estrangeiras do destino, esvazia todas as tabelas marcadas, as filhas antes das pais, e só então começa a carga.
- Como as tabelas são esvaziadas. No PostgreSQL, um só comando
TRUNCATEcita todas as tabelas de uma vez. Nos outros bancos, uma tabela pai referenciada por uma chave estrangeira é esvaziada comDELETE. - Sem CASCADE. O dbSlice não usa
CASCADE, que esvaziaria também tabelas que não estão na lista. - Ele se recusa antes de excluir qualquer coisa quando uma tabela fora da lista tem uma chave estrangeira apontando para uma tabela da lista, quando uma tabela filha vem antes da pai na lista, quando uma tabela de destino não existe ou quando as chaves estrangeiras não podem ser lidas.
- As tabelas ficam vazias até a carga terminar. Planeje uma janela de manutenção, e não rode contra um banco que aplicações estão lendo.
Identificadores depois de uma carga
Quando as linhas são copiadas com os identificadores que têm na origem, o destino não pode gerar esses valores de novo. Depois de gravar linhas com os ids da origem, o dbSlice avança o gerador de ids da tabela até o maior id gravado — sequences do PostgreSQL, colunas identity do Firebird 3+ e do Oracle 12c+ —, só para a frente, para a próxima inclusão no seu sistema não repetir um id. Se não conseguir (por exemplo, por falta de permissão), as linhas continuam gravadas e o log avisa que o seu DBA precisa avançar o gerador. Um gerador movido por trigger (no estilo do Firebird 2.5) não é ajustado. Isso vale também para a aba Synchronize.
5. Ordem de execução e chaves estrangeiras
As tabelas marcadas rodam na ordem da lista, uma por vez. A ordem da lista é a ordem de execução: o dbSlice nunca a reordena sozinho durante uma execução.
Isso importa quando o destino tem chaves estrangeiras. Uma tabela filha que roda antes da pai pode ser recusada por uma chave pai que ainda não chegou. Dois botões ajudam a definir a ordem.
- ▲ e ▼ sobem ou descem a tabela escolhida na lista.
- O Suggest order propõe uma ordem a partir das chaves estrangeiras do destino: uma tabela pai vem antes das filhas e, entre as tabelas que podem vir a seguir, a menor vem primeiro. É uma proposta; leia e ajuste com as setas antes de rodar.
Lembre também:
- Com o Full load, uma tabela filha que vem antes da pai na lista faz a execução se recusar antes de excluir qualquer coisa, como descrito acima.
- Confira a coluna de resultado depois da execução. Uma tabela que o banco recusa aparece como falha e pode ser rodada de novo depois da pai.
6. Rode, cancele e leia o resultado
Clique em Run synchronization. O log anuncia quantas tabelas serão replicadas, de qual conexão para qual e em que modo. Depois, para cada tabela, mostra a posição dela na execução, o par e uma linha de resultado.
Uma tabela concluída mostra as linhas lidas, as inseridas, as atualizadas por upsert ou update, o tempo total e o tempo dividido em leitura, transformação e gravação. O mesmo resultado aparece na coluna Result da lista, por exemplo 0 inserted, 120 updated.
Quando uma tabela falha
Uma tabela que falha não para as outras. A execução segue para a próxima tabela marcada, e a falha aparece na coluna Result e no log.
Quando a execução é cancelada
Clique em Cancel no painel Processing status para parar. A execução para no ponto em que está, e as tabelas que não tinham começado aparecem como não rodadas.
A última linha do log resume a execução: quantas tabelas terminaram, quantas falharam e quantas não rodaram. Uma execução está completa quando os dois últimos números são zero.
7. A conferência de chaves com o Record Diff
O Record Diff roda a mesma conferência só de chaves da aba Synchronize, para cada tabela marcada, e não grava nada.
- Mostra os totais da origem e do destino.
- Lista as chaves que faltam em cada lado, com uma amostra no log.
- O log mostra um relatório por tabela: totais de cada lado, quando cada lista foi montada e as chaves que faltam em cada lado.
- Escreve o resultado de cada tabela na coluna Result e colore a diferença:
equal — 1,204 rows on both sides, oumissing: target 39 · source 0. - Pode ser cancelado.
O Record Diff compara chaves, não valores. Duas linhas com a mesma chave e conteúdo diferente são, para o Record Diff, iguais. Para comparar valores, use o Compare com Also compare column values na aba Synchronize, como descrito no guia de conferência de bancos de gravação e de leitura.
Uma rotina prática é rodar o Record Diff antes da replicação, para ver o que falta, e de novo depois, para confirmar que as diferenças sumiram.
8. Salve, carregue e rode pela linha de comando
O Save grava a configuração num arquivo chamado *_replicator.json. O Load o reabre.
| O que é guardado | Detalhe |
|---|---|
| Origem e destino | Pelo nome do perfil de conexão. Nenhuma senha é gravada no arquivo. |
| Opções | Modo, tamanho de página e as três caixas de seleção. |
| A lista de pares | Tabela e chave de origem, tabela e chave de destino, e se a linha está marcada. |
| Regra de nomes | As máscaras de origem e de destino (por exemplo T* e TR*). |
O mesmo arquivo pode rodar sem a tela. O modo de linha de comando tem um job do tipo replicate que lê o arquivo salvo pela aba. Um modelo é criado com a opção --new, e o job também aparece na tela Jobs. Use quando a replicação se repete, por exemplo toda vez que um ambiente de teste é reconstruído.
9. Tabelas grandes e execuções interrompidas
Cada tabela roda como uma sincronia normal, com o mesmo motor da aba Synchronize. O Replicator não guarda um ponto de controle por tabela; então uma tabela interrompida não retoma de onde parou quando a execução é repetida nesta aba.
Para uma tabela muito grande, replique na aba Synchronize, onde uma execução interrompida retoma do seu ponto de controle, e deixe-a desmarcada no Replicator. A opção Don't count rows before starting também ajuda quando a contagem inicial é lenta.
10. Destinos NoSQL
O destino de uma replicação também pode ser um sistema NoSQL: MongoDB, Cassandra, Elasticsearch, Couchbase ou Redis. A origem continua sendo um banco relacional, como SQL Server, PostgreSQL ou MySQL. O mesmo vale para a aba Synchronize.
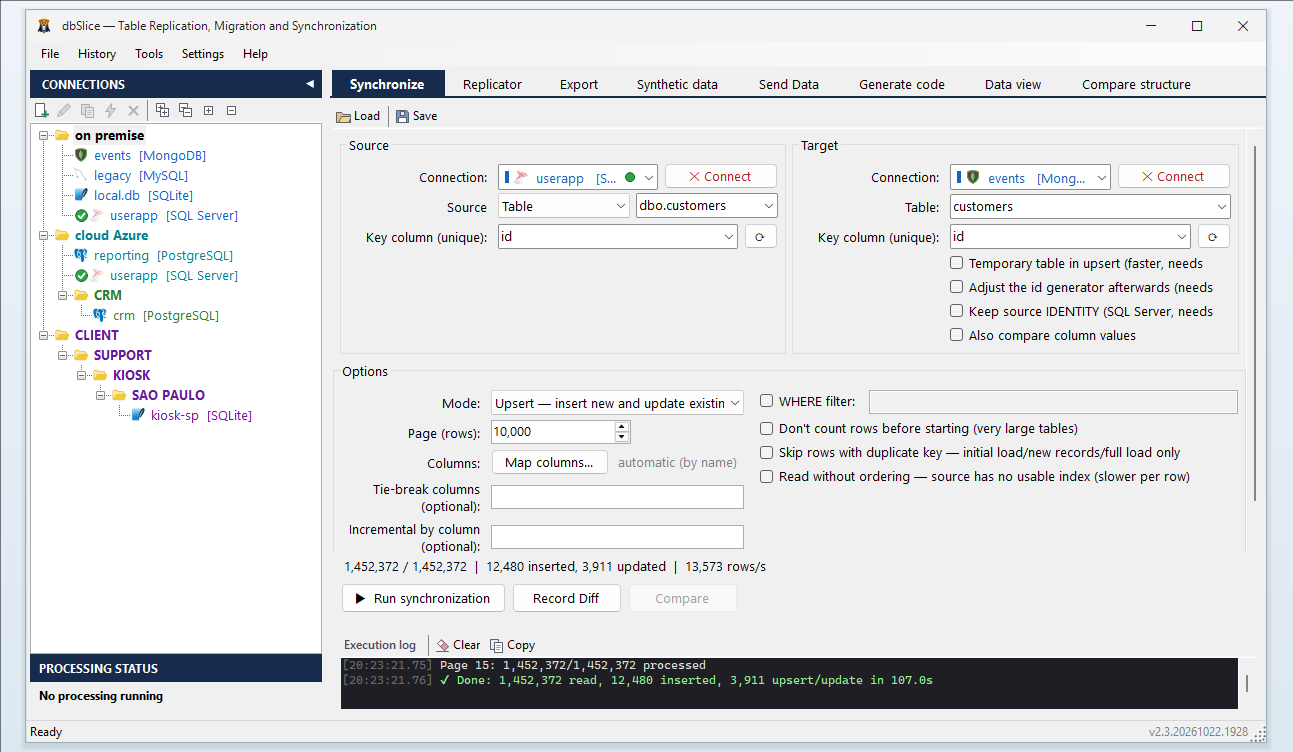
Os cinco modos estão disponíveis para todo destino NoSQL: Upsert, New rows only, Initial load, Update existing only e Full load.
| Destino | Como as linhas são gravadas |
|---|---|
| MongoDB | O valor da coluna-chave vira o _id do documento, e as outras colunas viram campos. A coleção é criada na primeira gravação. Os decimais são guardados sem perda, como Decimal128, e um Guid é guardado como UUID. |
| Cassandra | A tabela precisa existir, ou ser criada com Create table on target if missing, que converte os tipos das colunas. A coluna-chave vira a partition key. |
| Elasticsearch | O índice tem o nome da tabela, em minúsculas, e o _id de cada documento é a chave. O _source guardado mantém o número exato, mas o mapeamento automático do Elasticsearch trata um decimal como float. |
| Couchbase | A coleção é criada se não existir, e o id do documento é a chave. Um decimal é guardado como texto, para nenhum dígito se perder. |
| Redis | Cada linha vira um hash guardado em table:key, com um campo por coluna. Um valor nulo não grava campo. |
Números exatos no Elasticsearch e no Couchbase
- Elasticsearch. Para somar ou ordenar valores decimais com precisão, crie o índice antes, com o mapeamento que você quer. O dbSlice não muda o mapeamento de um índice que já existe.
- Couchbase. Como os decimais são guardados como texto, converta-os na consulta, por exemplo com
TONUMBERno SQL++. - Couchbase 7.x e Full load. Uma carga completa precisa de um índice primário na coleção. Sem ele, o dbSlice avisa e não exclui nada.
Estes limites valem hoje.
- NoSQL é só destino. O dbSlice não lê nem exporta dados desses sistemas.
- O Record Diff e o Compare ainda não funcionam com destino NoSQL. Uma replicação para um deles não pode ser conferida com esses botões.
- Só os cinco sistemas acima são suportados como destino NoSQL.
11. O que o Replicator não faz
- Não é contínuo. Uma execução começa quando você a inicia, pela tela ou como job. Ele não acompanha o log do banco de origem.
- Não filtra, não mapeia e não mascara por tabela. Não há filtro WHERE, mapeamento de colunas nem mascaramento nesta aba. As colunas são casadas pelo nome.
- Não reordena sozinho. O Suggest order propõe uma sequência, mas a execução segue a lista como você a deixar.
- Não usa consulta como origem. A origem é uma tabela.
- Não retoma uma tabela. A retomada é feita na aba Synchronize.
- Não exclui, exceto no Full load, que esvazia todas as tabelas marcadas antes de carregar. Nos outros modos, as linhas excluídas na origem continuam no destino.
- Não lê NoSQL. Os sistemas NoSQL são só destino.
- Não compara valores. O Record Diff confere chaves.
- Não substitui as suas regras. Constraints, triggers e permissões do destino valem como em qualquer gravação.
Uma primeira replicação com cuidado
- Conecte na origem e no destino e leia o número de tabelas carregadas em cada lado.
- Desmarque tudo e depois marque duas ou três tabelas pequenas.
- Confira os pares e as chaves dessas linhas.
- Escolha Upsert, ou Initial load se as tabelas de destino estiverem vazias.
- Rode o Record Diff primeiro e leia os totais.
- Rode a replicação e leia a coluna Result e o resumo final.
- Rode o Record Diff de novo e confirme que as diferenças sumiram.
- Marque o próximo grupo, as pais antes das filhas, e repita.
- Salve a configuração com Save.
Escopo deste guia
Os controles e as linhas de log descritos aqui foram tirados da aba Replicator do dbSlice 2.3. A ordem de execução, o tratamento de uma tabela que falha e de uma execução cancelada, os modos e as confirmações, as opções que não existem por tabela, o comportamento do Record Diff, o arquivo salvo e o job de linha de comando foram confirmados com a implementação do aplicativo.
A captura mostra conexões e tabelas de demonstração. O comportamento foi testado no laboratório de desenvolvimento com destinos PostgreSQL, MariaDB, MySQL 8.4, SQL Server, Firebird e Oracle, e com a cópia de SQL Server e PostgreSQL para MongoDB 8.2, Cassandra 5.0, Elasticsearch 8.17, Couchbase 8.0 e 7.2 e Redis 7.4, inclusive decimais, datas, uuids e textos longos (72 de 72 casos de laboratório); o laboratório não cobriu outros bancos para esta aba. No Oracle, a leitura e a gravação funcionam página a página. Nenhuma replicação foi executada para escrever este artigo, e nenhum número de velocidade ou capacidade é afirmado. O comportamento de novas tentativas e transacional do motor é o da aba Synchronize e não é descrito aqui como específico do Replicator.