
Precisa de linhas reais em vez de fictícias? →
Um ambiente novo quase nunca serve enquanto está vazio. As telas precisam de linhas para listar, os relatórios precisam de valores para somar e um teste de desempenho precisa de volume. O jeito mais rápido de conseguir esses dados é copiar da produção, e esse é justamente o jeito que leva registros de clientes para lugares onde eles não deveriam estar.
A aba Synthetic data oferece outro caminho. Ela lê o formato de uma tabela, deixa você escolher uma estratégia para cada coluna e gera quantas linhas o teste precisar. Nenhuma linha de origem é copiada: os valores são produzidos pelas estratégias que você escolhe.
Este guia segue a aba Synthetic data e a janela Field mapping do dbSlice 2.3. Ele explica as opções de cada coluna e como produzir um primeiro conjunto de dados com cuidado. A disponibilidade pode variar conforme a licença.
1. Linhas sintéticas ou uma cópia mascarada?
O dbSlice tem os dois caminhos, e eles atendem necessidades diferentes.
| Caminho | De onde vêm os valores | Use quando |
|---|---|---|
| Dados sintéticos | Das estratégias escolhidas para cada coluna. Nada é lido das linhas existentes, exceto as chaves das tabelas referenciadas. | O ambiente é novo, os dados reais não podem sair da origem, ou você precisa de mais linhas do que existem. |
| Sincronia mascarada | De linhas reais, com as colunas escolhidas substituídas antes da gravação. | Os testes dependem de distribuições reais, relacionamentos reais e casos extremos reais. |
O caminho mascarado está descrito em Mova os dados certos. Mascare antes de chegarem. Os dois podem ser combinados: sincronize as tabelas de referência que não têm dados pessoais e gere as que têm.
2. Leia a aba Synthetic data
A aba tem dois grupos, Model e Output, acima dos botões de ação e do log de execução.
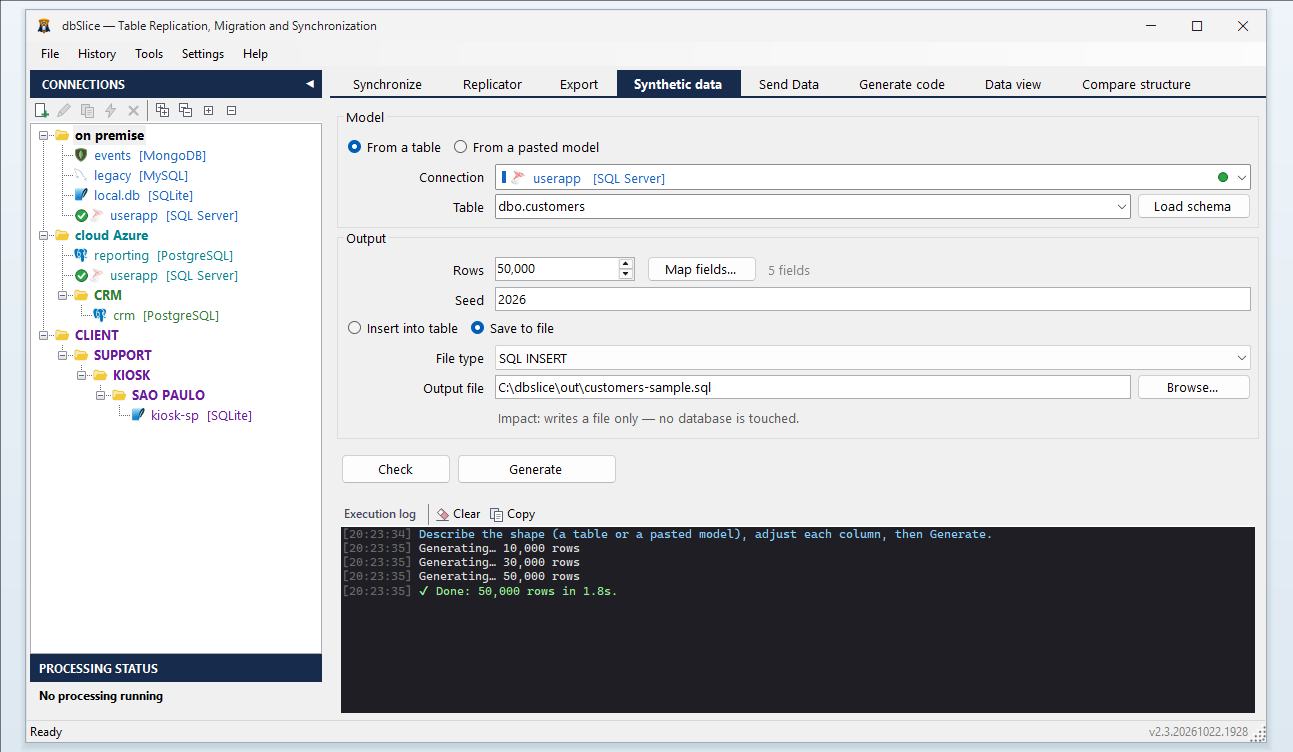
| Controle | Para que serve |
|---|---|
| From a table / From a pasted model | De onde vem o formato dos dados. |
| Connection e Table | A conexão salva e a tabela cuja estrutura será usada. |
| Load schema | Lê as colunas, os tipos e as chaves estrangeiras da tabela. |
| Rows | Quantas linhas gerar, até 5.000.000 por execução. |
| Map fields... | Abre o mapeamento de campos, onde cada coluna recebe uma estratégia. O rótulo ao lado mostra quantos campos foram encontrados. |
| Seed | Um valor opcional que torna a geração repetível. |
| Insert into table / Save to file | Se as linhas vão para uma tabela do banco ou para um arquivo. |
| Check | Valida o plano sem gerar nada. |
| Save layout / Load layout | Guardam o plano num arquivo .dgen.json e o abrem de novo depois. |
| Generate | Produz as linhas e grava na saída escolhida. |
O log começa com um resumo de uma linha do procedimento todo: descreva o formato, ajuste cada coluna e depois gere.
3. Descreva o formato dos dados
A partir de uma tabela
Escolha uma conexão e uma tabela e clique em Load schema. O dbSlice lê os nomes das colunas, os tipos de dados, se cada coluna aceita nulo e as chaves estrangeiras. É a escolha comum quando as linhas vão ser inseridas nessa mesma tabela em outro ambiente.
A partir de um modelo colado
Quando ainda não existe tabela, o formato pode vir de uma amostra que você cola: um objeto JSON, um array JSON, um CSV ou um trecho de XML. O dbSlice valida a estrutura e tira os campos dela. Isso serve para produzir um arquivo para um teste de API ou uma rotina de importação antes de o banco existir.
4. Associe cada campo a uma estratégia
Map fields... abre a janela Field mapping, com uma linha por coluna. A Strategy escolhida para cada coluna é a decisão central de todo o recurso.
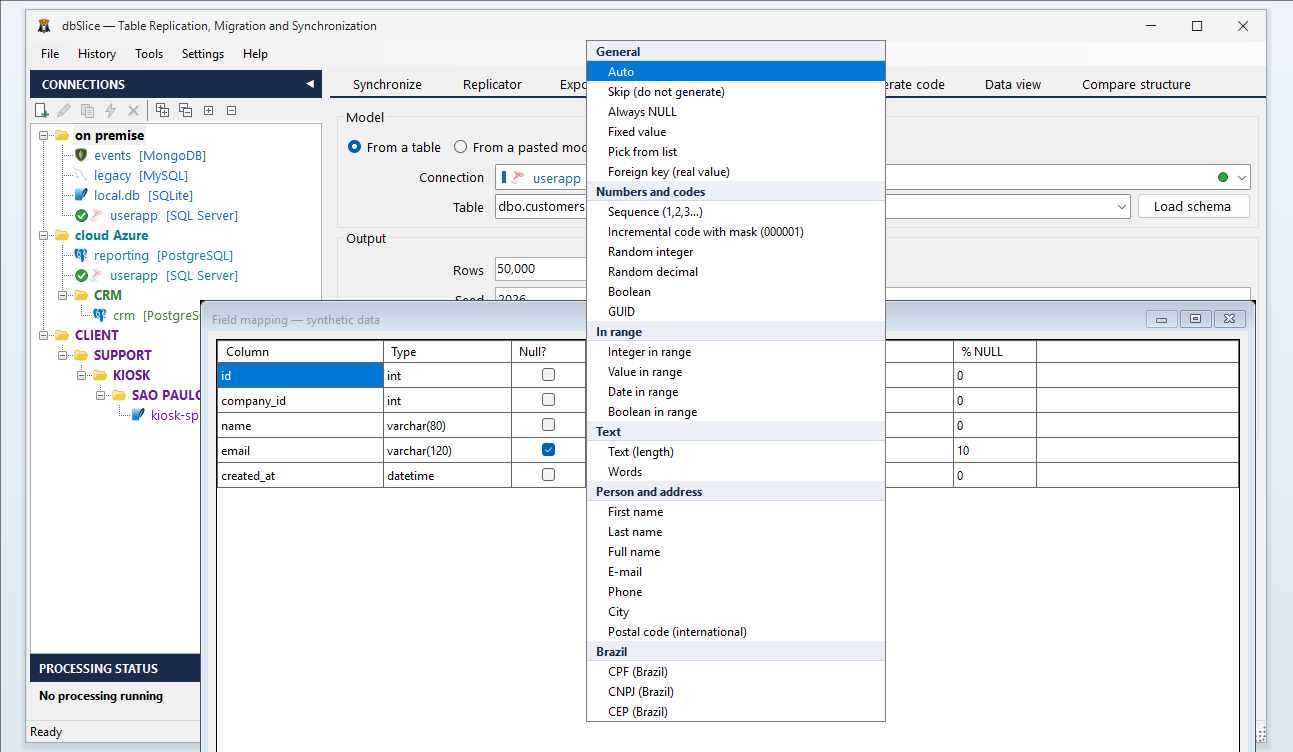
| Coluna da grade | Para que serve |
|---|---|
| Column | O nome da coluna lido da tabela ou do modelo. |
| Type | O tipo de dado da coluna, como int, varchar ou datetime2. |
| Null? | Se a coluna aceita nulo. |
| Strategy | Como os valores são produzidos, escolhida na lista da próxima seção. |
| Options | Parâmetros da estratégia. Quando uma estratégia usa opções, a grade preenche um exemplo para editar. |
| % NULL | A parcela das linhas, de 0 a 100, que recebe nulo. Vale só para colunas que aceitam nulo. |
| (última coluna, sem título) | Avisos e observações sobre a coluna, como FK → company.id. |
A janela tem o seu próprio botão Check, para revisar o plano sem sair dela.
5. O catálogo de estratégias
A lista tem 28 estratégias em seis grupos, organizados pelo tipo de valor produzido.
| Grupo | Estratégias | Uso típico |
|---|---|---|
| General | Auto, Skip (do not generate), Always NULL, Fixed value, Pick from list, Foreign key (real value) | Deixar o dbSlice decidir pelo tipo da coluna, deixar uma coluna para o padrão do banco, repetir uma constante ou sortear de uma lista curta, como códigos de status. |
| Numbers and codes | Sequence (1,2,3...), Incremental code with mask (000001), Random integer, Random decimal, Boolean, GUID | Identificadores, números de pedido de largura fixa, quantidades, valores e flags. |
| In range | Integer in range, Value in range, Date in range, Boolean in range | Valores que precisam ficar entre dois limites: uma idade, uma faixa de preço, um período de datas. |
| Text | Text (length), Words | Descrições, observações e colunas de texto livre. |
| Person and address | First name, Last name, Full name, E-mail, Phone, City, Postal code (international) | Tabelas de clientes, usuários e contatos. |
| Brazil | CPF (Brazil), CNPJ (Brazil), CEP (Brazil) | Tabelas que validam CPF, CNPJ e CEP. |
Auto é o ponto de partida de todas as colunas. Ele escolhe pelo tipo e pelo nome da coluna: uma coluna cujo nome contém email recebe e-mails, uma chamada cnpj recebe números de CNPJ, uma chave primária inteira recebe uma sequência, e uma coluna identity é pulada. Troque onde a aplicação dá à coluna um significado que o nome não revela, como uma coluna de status que precisa guardar os status que a aplicação conhece.
Opções de cada estratégia
| Estratégia | Opções | Exemplo |
|---|---|---|
| Integer in range, Value in range | min,max, obrigatório. O Value in range produz um decimal que respeita a precisão e a escala da coluna. | 1,1000 |
| Random integer, Random decimal | min,max, opcional. | 0,500 |
| Incremental code with mask | Uma máscara em que 9 é um dígito e o resto é texto literal. | 999999 dá 000001; ORD-9999 dá ORD-0001 |
| Boolean in range | true,false e uma parcela opcional de valores verdadeiros. Grava um par de valores, para colunas que guardam sim/não como número ou letra. | 1,0 · S,N · Y,N,80 |
| Date in range | yyyy-MM-dd,yyyy-MM-dd | 2020-01-01,2025-12-31 |
| Pick from list | Os valores, separados por vírgula. | a,b,c |
| Fixed value | O próprio valor. | BR |
| Text (length) | Tamanho min,max. | 10,40 |
| Words | O número de palavras. | 5 |
| Postal code (international) | Uma máscara em que 9 é um dígito e A é uma letra. Vazio significa 99999. | 99999-9999 · A9A 9A9 · 9999-999 |
Um plano para a tabela de usuários
Para a tabela da captura, um primeiro plano razoável seria:
| Coluna | Tipo | Estratégia | Motivo |
|---|---|---|---|
id | int | Sequence (1,2,3...), ou Skip se for uma coluna identity | Uma chave única e previsível. |
company_id | int | Foreign key (real value) | Precisa apontar para uma empresa que existe. |
permission_id | int | Foreign key (real value) | Precisa apontar para uma permissão que existe. |
username | varchar | Incremental code with mask | Valores únicos, fáceis de reconhecer como dados de teste. |
display_name | nvarchar | Full name | Nomes legíveis para telas e relatórios. |
email | nvarchar | Passa na validação de formato da aplicação. | |
is_active | smallint | Boolean in range, com 1,0,80 | Maioria de usuários ativos, com alguns inativos para testar filtros. |
created_at | datetime2 | Date in range | Datas espalhadas pelo período que os relatórios cobrem. |
Esta tabela ilustra como pensar a escolha. Não é o plano que o dbSlice propõe por padrão.
Colunas que precisam ser únicas
Só Sequence, Incremental code with mask e GUID produzem valores garantidamente distintos. As outras estratégias sorteiam valores e podem repeti-los. Use uma dessas três para chaves primárias e para colunas com constraint de unicidade, como username no plano acima.
6. Mantenha as chaves estrangeiras válidas
Uma linha gerada serve pouco se aponta para um pai que não existe. Quando o dbSlice carrega o esquema, ele reconhece as chaves estrangeiras e as marca na grade, como FK → company.id e FK → permission.id na captura.
A estratégia Foreign key (real value) lê as chaves distintas que existem na coluna referenciada, até 10.000 delas, e sorteia desse conjunto; então cada linha gerada aponta para um pai que existe. Se a referência de uma chave estrangeira não é conhecida, o Check bloqueia a geração.
Isso define a ordem do trabalho. Preencha primeiro as tabelas pais, sincronizando ou gerando, e gere as tabelas filhas depois. Se uma tabela pai está vazia, não há valor real para sortear.
7. Tipos, tamanhos e nulos
As estratégias trabalham dentro da definição da coluna. O texto respeita o tamanho máximo, os números respeitam precisão e escala, e uma coluna que não aceita nulo não recebe nulo. As colunas identity são puladas para o banco atribuir os valores.
Uma coluna obrigatória que é pulada depende de um padrão definido no banco. O Check avisa sobre isso.
O % NULL importa mais do que parece. Tabelas reais têm buracos, e um código que só viu linhas completas costuma falhar no primeiro telefone vazio. Dê às colunas opcionais uma parcela realista de nulos, para as telas e os relatórios serem testados com valores faltando.
8. Torne o resultado repetível com um seed
Sem seed, cada geração produz valores diferentes. Com o mesmo seed, o mesmo plano e o mesmo número de linhas, os valores são os mesmos.
Há uma exceção. O Foreign key (real value) depende das chaves que existem no banco naquele momento. Se a tabela pai muda, as referências geradas mudam também.
Use um seed quando o conjunto de dados faz parte de um teste: um teste automatizado que espera certo número de usuários ativos, um relato de bug que precisa ser reproduzido em outra máquina ou uma demonstração que deve aparecer igual toda vez. Registre o seed junto com o teste, como registraria qualquer outra entrada.
9. Escolha para onde vão as linhas
| Saída | O que acontece | Use quando |
|---|---|---|
| Insert into table | As linhas são inseridas, em lotes de 5.000, na tabela da conexão que você escolher. | Você está preenchendo um banco de desenvolvimento ou de teste diretamente. |
| Save to file | As linhas são gravadas como comandos SQL INSERT, CSV, JSON ou um banco SQLite (.db). Nenhum banco existente é tocado. | O script vai ser revisado, versionado ou rodado por outra pessoa, ou os dados alimentam uma importação ou um teste de API. |
A aba informa o efeito antes da execução. Com saída em arquivo, a linha abaixo do nome do arquivo diz:
Impact: writes a file only — no database is touched.Inserir numa tabela altera essa tabela. Confirme a conexão de destino e o ambiente dela antes de gerar, e espere um pedido de confirmação quando o perfil de destino estiver marcado como somente leitura.
Durante a execução, o log informa o progresso e termina com um resumo:
Generating… 10,000 rows
Generating… 30,000 rows
Generating… 50,000 rows
✓ Done: 50,000 rows in 1.8s.
Estas linhas vêm da tela de demonstração, que gravou um arquivo. Elas ilustram o formato do log. Não são uma medida de desempenho para o seu ambiente.
10. Confira antes de gerar
O Check valida o plano sem gerar nada. Algumas constatações bloqueiam a geração, e outras são avisos.
| Bloqueia a geração | Só avisa |
|---|---|
| Um número de linhas igual a zero ou menor. | Um tipo de coluna que o dbSlice não reconhece. |
| Uma coluna obrigatória definida como Always NULL, ou com um Fixed value vazio. | Uma coluna obrigatória pulada, que passa a depender de um padrão do banco. |
| Uma faixa ou um intervalo de datas mal formado. | Uma estratégia de texto numa coluna que não é texto. |
| Uma máscara inválida, no código incremental ou no código postal. | Sequence numa coluna que não é inteira. |
| Um par inválido em Boolean in range, ou um Pick from list vazio. | |
| Uma chave estrangeira cuja referência não é conhecida. |
Comece com poucas linhas. Cem linhas bastam para ver se os valores parecem certos, se as chaves estrangeiras resolvem e se a aplicação os aceita. Aumente o volume depois disso.
11. Identificadores com cara de reais
O grupo Brazil produz valores no formato de CPF, CNPJ e CEP, para as aplicações que validam esses campos os aceitarem. CPFs e CNPJs são gerados com dígitos verificadores válidos, e o CNPJ é o de uma matriz (/0001). O CEP segue só o formato NNNNN-NNN e não corresponde a um endereço real. Os telefones usam o formato (NN) NNNNN-NNNN.
Um número que passa na validação pode coincidir com o número de uma pessoa ou empresa real. Trate os identificadores gerados como valores de teste: não os envie a serviços externos, birôs de crédito, sistemas fiscais ou qualquer coisa que agiria sobre eles. O mesmo cuidado vale para os e-mails e telefones gerados, que nunca devem receber mensagens reais. Mantenha os ambientes de teste desconectados dos canais de entrega reais.
12. O que os dados sintéticos não entregam
- Não são uma cópia estatística. Os valores seguem as estratégias que você escolheu. Eles não reproduzem as distribuições, as correlações nem os casos incomuns dos seus dados de produção.
- As colunas são geradas de forma independente. Nenhuma coerência entre colunas é garantida. Um e-mail gerado é montado a partir de um nome sorteado para aquele valor, não do nome ou do nome completo da mesma linha, e cidade, código postal e telefone não combinam entre si.
- Roda pela tela. Um layout salvo é reaberto na aba. Ele não roda como job nem pela linha de comando.
- Não conhece as suas regras de negócio. Uma regra como "um pedido fechado tem data de fechamento" não está na definição da tabela. Confira as combinações entre colunas numa amostra, e ajuste o plano ou os dados onde a aplicação depende delas.
- Não substitui a validação com dados reais. Antes de uma entrega, alguns testes ainda precisam de um extrato controlado e mascarado de linhas reais.
Uma primeira geração com cuidado
- Preencha ou sincronize as tabelas pais que a tabela de destino referencia.
- Escolha From a table, selecione a conexão e a tabela e clique em Load schema.
- Abra Map fields... e troque o Auto onde a coluna tem um significado para a aplicação. Dê às colunas únicas uma sequência, um código incremental ou um GUID.
- Confirme que as colunas de chave estrangeira usam Foreign key (real value).
- Defina o % NULL das colunas opcionais.
- Ponha um número pequeno em Rows e escolha um Seed.
- Escolha Save to file primeiro e leia o resultado.
- Rode o Check e corrija o que ele apontar.
- Mude para Insert into table, confirme o ambiente de destino e gere.
- Abra a aplicação sobre as linhas geradas antes de aumentar o volume.
- Use Save layout para guardar o plano para a próxima vez.
Escopo deste guia
Os controles, a lista de estratégias e as linhas de log descritos aqui foram tirados de capturas da aba Synthetic data e da janela Field mapping do dbSlice 2.3. As colunas da grade, as opções de cada estratégia e o comportamento dos modelos colados, das chaves estrangeiras, das restrições das colunas, do seed, das conferências e dos formatos de saída foram revisados com a implementação do aplicativo. O plano para a tabela de usuários da seção 5 é uma ilustração escrita para este guia.
Nenhum conjunto de dados foi gerado para escrever este artigo, e nenhuma taxa de geração é afirmada. As capturas usam tabelas sintéticas de documentação; um nome de conexão foi removido da captura do mapeamento de campos.