Migrar um banco muda mais do que o lugar onde os registros ficam. Muda como as aplicações interpretam valores, geram identificadores, garantem relacionamentos e se recuperam de falhas. Uma cópia concluída é um marco; uma migração concluída é o sistema novo servindo o negócio com dados confiáveis.
Uma estratégia de migração de dados define o que vai mudar de lugar, como será transformado, como as alterações serão tratadas durante a transição e que evidências são exigidas antes de a produção passar para o destino.
Este guia é um roteiro prático para desenvolvedores, DBAs, DevOps e equipes de dados, e mostra onde o dbSlice entra: mover e conferir dados entre os principais bancos do mercado, aplicar mapeamentos e máscaras escolhidos e transformar as etapas de dados em jobs repetíveis.
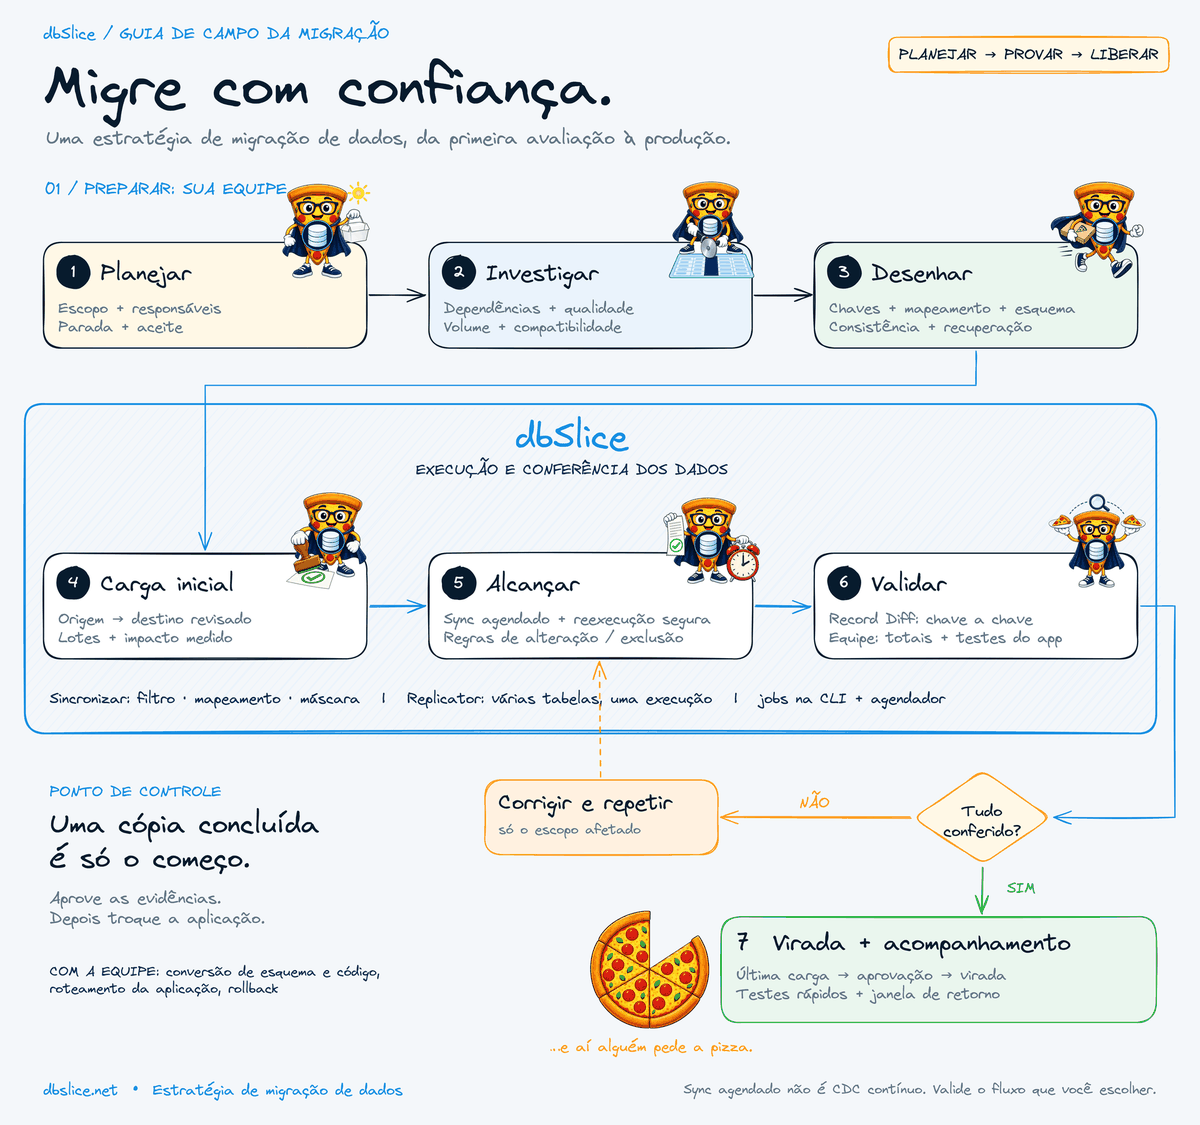
Planeje a migração, rode operações de dados repetíveis e libere só depois de validar.
O que uma estratégia de migração precisa ter?
Comece por um acordo escrito entre o dono da aplicação, a equipe de banco de dados e a operação. Ele deve nomear o escopo, os responsáveis, a parada permitida, os objetivos de recuperação, as regras de conferência e as condições de retorno (rollback).
Torne o aceite mensurável. "Os dados parecem certos" é difícil de defender. "Todas as chaves de cliente existem, os totais de pedidos batem, não há órfãos sem explicação e os testes críticos da aplicação passam" é uma decisão de liberação que alguém consegue revisar.
Separe a movimentação de dados das mudanças de aplicação e de código do banco. Copiar tabelas não traduz procedures, triggers, views, permissões nem as consultas da aplicação. O guia de Oracle para PostgreSQL deixa essa fronteira clara: o dbSlice cuida dos dados; o código do banco precisa de conversão e revisão próprias.
Fatores que moldam a migração
| Fator | Perguntas | Efeito no plano |
|---|---|---|
| Impacto no negócio | Que serviços dependem desses dados? Quanto tempo a gravação pode parar? | Define o horário da virada e os ensaios. |
| Volume e formato | Quantos bytes, linhas largas, objetos grandes e partições históricas? | Dimensiona a transferência, os lotes e o custo de validar. |
| Taxa de mudança | Com que velocidade chegam inserts, updates e deletes? | Diz se a atualização agendada consegue alcançar. |
| Compatibilidade | Tipos, encoding, collation e fuso horário batem? | Gera mapeamentos e mudanças de aplicação a testar. |
| Identidade e relações | As chaves são estáveis? Que tabelas-pai vêm primeiro? | Define a ordem de carga e as reexecuções seguras. |
| Acesso e capacidade | Que permissões, rede e recursos existem? | Limita ferramentas, vazão e impacto. |
| Segurança e recuperação | Que campos são sensíveis? Como provar a recuperação? | Define máscara, acesso, evidências e rollback. |
Use a tabela como checklist de descoberta e troque suposições por medidas do seu ambiente.
Passo 1: escopo, responsáveis e critério de sucesso
Liste tabelas, períodos e entidades que vão para o destino, incluindo relatórios, integrações, tarefas agendadas e exportações que ainda leem o sistema antigo. Dê um dono a cada teste de aceite: o DBA confere chaves e restrições; a área de negócio confirma que faturas, saldos e status de pedidos continuam significando a mesma coisa. Defina RTO e RPO da transição, quem pode parar a migração e que evidência autoriza a virada — antes do primeiro ensaio.
Passo 2: investigue a origem e avalie o destino
Inventarie tabelas, chaves, dependências, índices, geradores de identidade e código do banco. Faça o perfil dos dados: nulos, chaves de negócio duplicadas, textos enormes, datas estranhas, encoding inesperado. Avalie a aplicação junto com o banco: ela pode depender de comparação sem diferenciar maiúsculas, de conversões implícitas ou de SQL específico do fabricante. Em sistemas legados grandes, meça a consulta de extração real: uma view complicada pode dominar o tempo mesmo com o destino gravando rápido.
Passo 3: escolha o padrão de migração
| Padrão | Quando serve | Contrapartida |
|---|---|---|
| Offline | Uma parada planejada comporta cópia e conferência. | Consistência simples; parada maior. |
| Em fases | Entidades, clientes ou serviços mudam separadamente. | Liberações menores; mais convivência e roteamento. |
| Carga inicial + atualização agendada | Chaves estáveis e um jeito confiável de achar o que mudou. | Parada final menor; o frescor depende da duração e da frequência do job. |
| CDC por log | O projeto exige captura contínua e os bancos suportam. | Ferramenta, permissões e operação dedicadas. |
O dbSlice faz cargas iniciais e jobs de sincronização repetíveis (upsert, só novos e incremental), como mostra o guia de SQL Server para PostgreSQL. Não é CDC por log. Sincronização agendada não é migração "sem parada" automática: se a gravação continua, prove que o seu método pega as alterações e que a política de exclusão está completa.
Passo 4: mapeamentos, chaves e consistência
Escreva a especificação de mapeamento: colunas de origem e destino, conversões, valores padrão e chaves de comparação. Revise precisão decimal, fuso horário, tamanho de texto, Unicode e nulos. Preserve identificadores quando aplicações ou integrações dependem deles.
Use a Sincronização do dbSlice quando a tabela precisa de consulta como origem, filtro, mapeamento de colunas ou máscara; o guia de movimentação controlada explica esses controles e por que tirar um campo do mapeamento não prova que ele deixou de ser lido na origem.
Defina também a fronteira de consistência: páginas lidas de um banco que está mudando podem representar momentos diferentes. Paginação rápida, sozinha, não cria um retrato consistente entre tabelas.
Passo 5: ensaie com dados representativos
Escolha um piloto com valores difíceis, objetos grandes, pai e filho e linhas muito atualizadas. Rode extração, transformação, carga, conferência e testes da aplicação de ponta a ponta, com uma interrupção controlada para provar a recuperação. Meça a duração e o impacto na origem, corrija e ensaie de novo. Teste as regras de máscara em cópias fora de produção, inclusive se os valores mascarados mantêm unicidade e relacionamentos.
Passo 6: carga inicial com o dbSlice
Confirme conexões, chaves, mapeamentos e modo de gravação antes de rodar; guarde a configuração revisada com o runbook e mantenha credenciais fora das definições de job. Para muitos pares de tabelas simples, o Replicator roda as tabelas escolhidas numa execução só; use a Sincronização quando a tabela precisar de filtro, mapeamento ou máscara. O guia do Replicator lembra que o Record Diff dele confere só as chaves e que retomar uma tabela interrompida se faz na Sincronização. Respeite a ordem das dependências e acompanhe latência na origem, capacidade de gravação, armazenamento e log de transações.
Passo 7: alcance as mudanças e torne as reexecuções previsíveis
Se a origem continua ativa, documente como cada execução encontra as mudanças. Uma coluna updated_at não basta: teste commits atrasados, timestamps iguais e linhas alteradas sem mudar a data. Escrevemos sobre as duas armadilhas mais comuns em Incremental sync missing rows? (em inglês).
Exclusões precisam de regra explícita. O upsert insere e atualiza; sozinho, não remove do destino o que foi apagado na origem. Escolha marcação lógica (tombstone), conferência controlada ou recarga final.
Para repetir, o dbSlice salva jobs que rodam pela linha de comando com o Agendador de Tarefas do Windows ou o cron; o guia de automação mostra logs, códigos de saída, jobs de status e avisos. Decida como evitar execuções sobrepostas e como tratar uma execução parcial.
Passo 8: valide o técnico e o negócio
Valide com o mesmo escopo e a mesma fronteira. Use camadas de evidência:
- Cobertura: tabelas, partições e faixas de chave estão lá.
- Identidade: chaves faltando, sobrando e duplicadas estão explicadas.
- Valores: colunas críticas batem segundo as regras de conversão.
- Relacionamentos: restrições e verificação de órfãos passam.
- Significado de negócio: totais, saldos e status batem.
- Prontidão da aplicação: leitura, gravação e integrações funcionam no destino.
Contagem igual é só triagem. A Comparação do dbSlice confere duas tabelas chave a chave e lista o que falta, o que sobra e o que tem valor diferente. Reserve tempo e capacidade: validar lê os dois bancos de novo.
Passo 9: virada, acompanhamento e caminho de volta
Use um checklist com horário: pare ou roteie as gravações, escoe o que está em andamento, rode a última atualização, confira a fronteira combinada, obtenha a aprovação, troque as conexões da aplicação e rode os testes rápidos. Deixe claro o limite do rollback: antes de o destino aceitar gravações, voltar é simples; depois, voltar pode perder dados novos sem um caminho de volta testado. Acompanhe erros, latência, totais de negócio e filas durante a estabilização. Desligue a origem só depois do aceite. Aí sim, peça a pizza.
Boas práticas que tornam a estratégia repetível
- Mapeamentos e jobs sob controle de mudança; mudou, ensaie de novo.
- Permissão mínima para cada operação; proteja os arquivos exportados.
- Teste a recuperação no mesmo modo e fluxo planejados para produção.
- Reserve tempo para validação, atualização e decisão na estimativa de parada.
- Meça com dados representativos e restrições parecidas com produção.
- Guarde as evidências: configuração, horários, fronteiras, logs, diferenças e aprovações.
Como referência, o dbSlice publica um exemplo de produção com 12,96 bilhões de linhas em 1 dia, 16 horas e 40 minutos, com as condições descritas na página de desempenho. É um resultado do fabricante, não uma garantia nem uma comparação independente: use o seu piloto para estimar a sua janela.
Coloque em prática
Comece com uma tabela representativa e um checklist de aceite escrito. Monte o mapeamento, rode a carga inicial, exercite as regras de atualização e confira o resultado antes de ampliar o escopo. O dbSlice traz movimentação, sincronização e conferência para esse fluxo; a equipe continua responsável pela compatibilidade, pela aplicação e pela liberação em produção.
Conheça o dbSlice, leia os guias e veja edições e preços. A versão gratuita está na Microsoft Store; gravar num banco de destino exige licença Desktop ou Server.
Vai trocar de sistema e precisa de ajuda para desenhar a convivência dos dados? A Thinwork conduz o projeto com você.
Perguntas frequentes
Qual a diferença entre migração e sincronização de dados?
Migração move uma carga definida para um destino como parte de uma transição. Sincronização repete operações para manter uma relação combinada entre sistemas. Uma migração pode usar sincronização enquanto os dois sistemas convivem.
Dá para migrar um banco sem parada?
Algumas arquiteturas permitem interrupções muito curtas, mas isso depende de captura de mudanças, roteamento, transações e do desenho da aplicação. Um job agendado de cópia, sozinho, não garante isso.
Onde o dbSlice entra numa estratégia de migração?
Na transferência dos dados, em transformações e máscaras escolhidas, na sincronização repetível e na conferência. Revisão de esquema e de código, aceite do negócio, troca da aplicação e rollback continuam sendo frentes do projeto.
Como estimar a janela de migração?
Meça extração, transformação, carga, última atualização e conferência no ensaio. Some o tempo de parar as gravações, decidir a liberação e testar a aplicação, mais uma folga baseada na variação observada.