Datenmigration, Replikation und Synchronisierung für die führenden Datenbanken

dbSlice by Thinwork verschiebt die Daten, hält beide Seiten synchron und belegt die Übereinstimmung.

Kostenlos testen – Microsoft Store ↗ Preise ansehen →

Seit über 6 Jahren im Produktiveinsatz · 14 Tage Geld-zurück · Läuft auf Ihrem Rechner

SOURCEsqlserver://erp.dbo.OrdersTARGETpostgres://erp.public.orders
Zeilen gelesen
12.480.316
Zeilen geschrieben
12.480.316
fehlen im Ziel
0
abweichende Werte
0

IDENTISCH 00:04:12

winget install --id 9PMS69X1T53Z -e --source msstore
choco install dbslice

Installations- und Aktivierungsanleitung

Auf beiden Seiten: SQL Server · PostgreSQL · Oracle · MySQL · MariaDB · Firebird · SQLite · InterSystems IRIS/Caché · und weitere

Von der ersten Kopie bis zur Umstellung

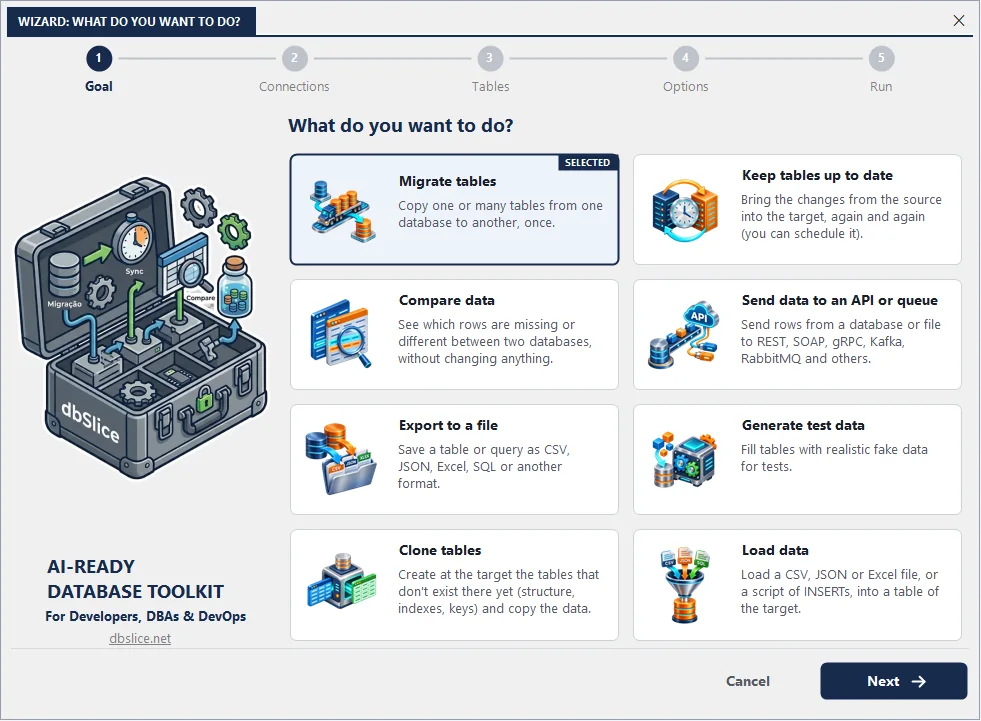
Neu: ein Assistent in fünf Schritten. Wählen Sie, was Sie tun möchten (migrieren, Tabellen aktuell halten, vergleichen, an eine API senden, exportieren, Testdaten erzeugen, klonen oder laden), verbinden Sie beide Datenbanken, wählen Sie Tabellen und Optionen und starten Sie den Lauf. Alle erweiterten Registerkarten bleiben erhalten.

dbSlice-Assistent, Schritt 1 von 5: Daten migrieren, aktuell halten, vergleichen, senden, exportieren, erzeugen, klonen oder laden
  1. Schritt 1

    Einmal migrieren

    Tabellen zwischen Datenbanksystemen kopieren – mit Typzuordnung, schlüsselgenauem Abgleich und Prüfungen auf dem Bildschirm vor dem Schreiben.

    Migrationsleitfäden →
    1 Quelle · 2 Ziel · 3 Schlüsselspalte zum Abgleich der Zeilen
  2. Schritt 2

    Bis zur Umstellung synchron halten

    Upsert, Nur-neu-einfügen oder inkrementelle Läufe jede Nacht, solange das Altsystem noch aktiv ist. Alt- und Neusysteme, On-Premises und Cloud, eine Datenbank und ein CRM – sie teilen sich über Monate Daten. dbSlice hält sie als geplante Jobs im Gleichschritt, innerhalb Ihrer eigenen Infrastruktur.

    Leitfaden Synchronisieren →
    Page 13: 1,300,000/1,452,372 processed
    Page 14: 1,400,000/1,452,372 processed
    Page 15: 1,452,372/1,452,372 processed
    Done: 1,452,372 read, 12,480 inserted, 3,911 upsert/update in 107.0s
  3. Schritt 3

    Übereinstimmung belegen

    Fehlende oder abweichende Datensätze erkennen, Spaltenunterschiede prüfen und IDs für eine gezielte Korrektur exportieren.

    Quelle und Ziel vergleichen →
    1 Zusammenfassung: 16 Spalten, 9 Unterschiede · 2 eine Spalte, die nur in der Quelle existiert
  4. Schritt 4

    Umstellen

    Transaktionale Batches, Fortsetzung ab einem Checkpoint, Wiederholungen bei vorübergehenden Fehlern und ein Verlauf jedes Laufs. Ein Job, ein Zeitplan, ein Protokoll. Setzt dort fort, wo er angehalten hat, und berichtet per E-Mail und Webhook.

    So funktioniert das Nebeneinander von Daten →
    1 Vergleichen · 2 gleiche Anzahl in Quelle und Ziel · 3 0 fehlend · 4 0 Zeilen mit abweichenden Werten

Den Vorgang vor dem Start ansehen

Quelle, Ziel, Modus, Zuordnungen und Fortschritt auf einem Bildschirm.

Replikator: viele Tabellen in einem Lauf kopieren

Wählen Sie die Tabellen und kopieren Sie alle in einem Lauf, Eltern vor Kindern, mehrere Tabellen parallel. Damit verschieben Sie einen ganzen Satz Tabellen in eine andere Datenbank oder aktualisieren eine Testumgebung.

Gemessene Zahlen, mit ihren Bedingungen

LaufZeilenZeitRateBedingungen
Kopie/Synchronisierung in Produktion12.96 Mrd.1 d 16 h 40 min≈88,500/sProduktive Live-Tabelle, 40 Spalten und 9 Indizes; Netzwerk und Datenbanken abgestimmt. Details
Erstladung nach Azure SQL31.4 Mio.≈30 min≈17,200/sSQLite-Quelle auf einem lokalen Datenträger, Desktop-App, September 2026, vor unseren Optimierungen im September und Oktober.
1 Million fehlende Zeilen in PostgreSQL wiederherstellen1 Mio.10.6 sZeit vorher: 21 minUpsert-Option mit temporärer Tabelle aktiv; SQL Server 2022 → PostgreSQL 17 auf demselben Host, Labor.

Der Durchsatz hängt von Volumen, Netzwerk, Datenbanksystemen, Zeilenbreite, Tuning und Transformationen ab. Ihre Zahlen werden abweichen. Vollständige Methode →

Gemacht für Produktionsdatenbanken

Seit mehr als sechs Jahren in geschäftskritischen Umgebungen im Produktivbetrieb, über mehrere Rechenzentren hinweg und On-Premises, mit SQL Server, PostgreSQL, Aurora und InterSystems IRIS/Caché. Kundenberichte lesen →

  • Umgebungen, die sich nicht verwechseln lassenDEV, QA, UAT und Produktion sind benannt und farbig gekennzeichnet; dbSlice warnt, bevor ein Vorgang sie überschreitet.
  • Ihre Datenbank bleibt IhreEs liest und schreibt Zeilen; standardmäßig legt es keine Objekte in Ihren Datenbanken an.
  • Geschützte ZugangsdatenVerbindungsprofile werden auf Ihrem Rechner verschlüsselt, und Job-Dateien enthalten keine Passwörter.
  • Sichere LäufeTransaktionale Batches, Fortsetzung ab einem Checkpoint, Wiederholungen bei vorübergehenden Fehlern und ein Verlauf jedes Laufs.

Was Ihre Daten berührt

dbSlice läuft dort, wo Sie es einsetzen: auf Ihrem Windows-Rechner oder Server oder in Ihrem eigenen Docker. Es liest die Quelle schlüsselbasiert in kleinen Batches und schreibt nur Zeilen in das Ziel. Standardmäßig legt es nichts in Ihren Datenbanken an, und dbSlice sendet niemals Datenbankzeilen an Thinwork. Tritt ein unerwarteter Fehler auf, können Sie die Details per E-Mail an den Support senden: Sie sehen den Text, bevor Sie ihn absenden.

dbSlice runs on your machine or in your Docker. It reads the source by key in small batches and writes only rows to the target. By default it creates nothing in your databases. Database rows do not go to Thinwork. With Thinwork, only license activation and renewal, the update check and download, and the release notes list leave your network, with no database rows. An error report e-mail goes to Thinwork only if you choose to send it, after you review it; an error message can quote a value. Destinations you configure yourself (e-mail, webhook, REST, SOAP, gRPC, brokers, telemetry) receive what you send them.

Your network

Source databaseread by key, in small batches
↓
dbSliceyour Windows machine or server, or your own Docker
↓
Target databaseonly rows written; anything else asks first

By default, nothing is created in your databases: no triggers, tables or agents. dbSlice never sends database rows to Thinwork.

Leaves your network

With Thinwork, no database rows sent:
  • license activation and renewal
  • update check and download
  • release notes list
  • an error report e-mail, only if you choose to send it (you review it; an error text may quote a value)
Only if you set them up:
  • e-mail (SMTP), webhook, REST API
  • SOAP (and its WSDL), gRPC, broker
  • your telemetry collector

Die führenden Datenbanken, auf beiden Seiten

Eine Lizenz deckt alle ab. Neue Datenbanken kommen mit regulären Updates. Schreibt auch in MongoDB, Cassandra, Elasticsearch, Couchbase und Redis.

Jede davon, als Quelle oder Ziel:

  • SQL Server
  • PostgreSQL
  • Oracle
  • MySQL
  • MariaDB
  • Firebird
  • SQLite
  • InterSystems IRIS/Caché

Einschließlich InterSystems IRIS/Caché und Firebird, die nur wenige Migrationstools abdecken.

Auch unter Linux, in Docker: dieselben Werkzeuge im Browser, mit Scheduler und API. Linux-Edition →

Ein Benutzer. Ein Gerät. Ihre berechtigte Version bleibt Ihre.

  • Desktop-Edition

    US$ 89.99

    1 benannter Benutzer · 1 aktiviertes Gerät · Einmalzahlung

  • Windows-Server-Edition

    US$ 199.99

    1 Windows-Server-Installation · Einmalzahlung

  • Linux-Server-Edition (Docker)

    US$ 299.99 / Jahr

    1 Linux-Server, mehrere Instanzen (Docker) · Jahresabonnement

Preise ansehen und kaufen → Desktop und Windows Server: Die Lizenz umfasst die Windows-Oberfläche, die CLI, 12 Monate Updates und Standard-Support.

Wer dbSlice entwickelt

Junior Oliveira, Thinwork

Ein kleines Team bei Thinwork, einem Softwareunternehmen seit 2007, geleitet von Junior Oliveira (40 Jahre in der IT). Jede E-Mail wird von den Menschen gelesen, die dbSlice entwickeln. Über Thinwork und dbSlice →

Leitfäden

Migration nach Paar

Bis zur Umstellung synchronisieren

Belegen und testen

Alle Leitfäden →